Статистика — это язык, на котором аналитик обосновывает решения. Без неё данные остаются набором цифр: отчёт есть, вывода нет. Статистика и аналитика данных неразрывно связаны: первая даёт математический инструментарий, вторая — контекст и цель. Статистика для аналитика данных решает четыре задачи: описывает выборку, сравнивает группы, проверяет предположения и строит прогнозы.
В статье разберём пять ключевых блоков: описательная статистика, разведочный анализ данных (EDA), вероятностные распределения, проверка гипотез и A/B-тестирование как пример их практического применения. Каждый блок опирается на предыдущий — можно двигаться последовательно или переходить сразу к нужной теме.

Сделайте следующий шаг в карьере
Подберите обучение, которое поможет освоить новые компетенции
Аналитик использует статистику везде: при запуске A/B-теста, поиске аномалий в продажах, сегментации аудитории и подготовке входных данных для ML-пайплайна (набора алгоритмов машинного обучения).
Разница между аналитиком данных и специалистом по анализу данных (Data Scientist): аналитик отвечает на вопрос «что происходит и почему», обосновывает бизнес-решения. Data Scientist строит и обучает модели. Статистика нужна обоим, но объём разный — аналитика и статистика в этом смысле пересекаются, но не совпадают.
Минимум по уровням:
Описательная статистика — набор методов, которые сжимают данные до понятных характеристик: что типично, насколько данные разбросаны, есть ли выбросы. Она описывает то, что есть в выборке, но не делает умозаключений о генеральной совокупности — этим занимается инференциальная (логическая) статистика. Расчёт описательных показателей в таблицах подробнее рассмотрен в материале об описательной статистике в Excel.
Три основных показателя «центра» данных:
Когда применять: при симметричном распределении среднее и медиана совпадают, оба информативны. При скошенном — медиана точнее. Пример: средний чек в магазине — 2 500 ₽, медианный — 800 ₽. Небольшая доля крупных заказов тянет среднее вверх — медиана точнее описывает «типичного» покупателя. Для категориальных данных (тип устройства, регион) используйте моду: она показывает наиболее распространённый вариант.
Меры центра дают одно число — меры разброса объясняют, насколько данные вокруг него расходятся.
Прежде чем запускать тесты, нужно разобраться в самих данных. Разведочный анализ данных — EDA (Exploratory Data Analysis) — начальный этап работы: понять структуру, найти ошибки и аномалии, сформулировать первые гипотезы. Опытный аналитик не переходит к тестам сразу — он начинает с EDA.
Пять задач разведочного анализа данных:
| Критерий |
EDA |
Классический статистический анализ |
|---|---|---|
| Цель | Понять данные, найти гипотезы | Проверить конкретную гипотезу |
| Начало | До выбора теста | После формулировки H0 и H1 |
| Инструменты | Графики, описательная статистика | Тесты, p-value, доверительные интервалы |
| Результат | Список предположений | Статистический вывод |
Результат EDA — не окончательный вывод, а список предположений, которые станут основой для формальных статистических тестов.
Визуализация данных — основной инструмент разведочного анализа. Четыре ключевых типа:
Выбросы не удаляйте автоматически. Выброс может быть ошибкой в данных, а может — реальным событием (крупный заказ, сбой системы). Сначала выясните причину, потом решайте.
Форма распределения данных определяет, какие статистические методы применимы. Нормальное распределение — основа большинства параметрических тестов; при его отсутствии нужны непараметрические аналоги или преобразование данных. Виды статистического анализа напрямую зависят от того, с каким распределением работает аналитик.
Разобраться с распределениями, проверкой гипотез и методами обработки данных на практике поможет программа Data-аналитик: Python и SQL в анализе данных — 2 месяца с господдержкой (75% стоимости компенсирует образовательная квота). Здесь разберём теорию.
Нормальное распределение («колокол») описывается двумя параметрами: μ (среднее) и σ (стандартное отклонение). Правило трёх сигм:
Как проверить нормальность: постройте гистограмму (похожа на колокол?) и Q-Q plot (квантиль-квантильный график, где точки вдоль прямой указывают на нормальность) или запустите тест Шапиро-Уилка в Python через scipy.stats.shapiro.
Центральная предельная теорема (ЦПТ): при объёме выборки n > 30 распределение выборочного среднего стремится к нормальному — даже если исходные данные не нормальны. Это обосновывает применение z-тестов и t-тестов в большинстве практических задач.
Два распределения, с которыми аналитик сталкивается регулярно.
Биномиальное — описывает число «успехов» в n независимых испытаниях с вероятностью p. Применяется для конверсий: сколько из n пользователей совершат целевое действие.
Пуассона — описывает число событий за фиксированный период при постоянной средней интенсивности. Применяется для подсчёта заказов в час, ошибок в день, кликов в минуту.
Правило выбора: биномиальное — когда считаете «успехи» из фиксированного числа попыток; Пуассона — когда считаете события за время без ограничения на их число.
Гипотеза — предположение о данных, которое можно проверить числами. Нулевая гипотеза H0 говорит «эффекта нет», альтернативная H1 — «эффект есть». Задача теста — решить, достаточно ли данных, чтобы отвергнуть H0.
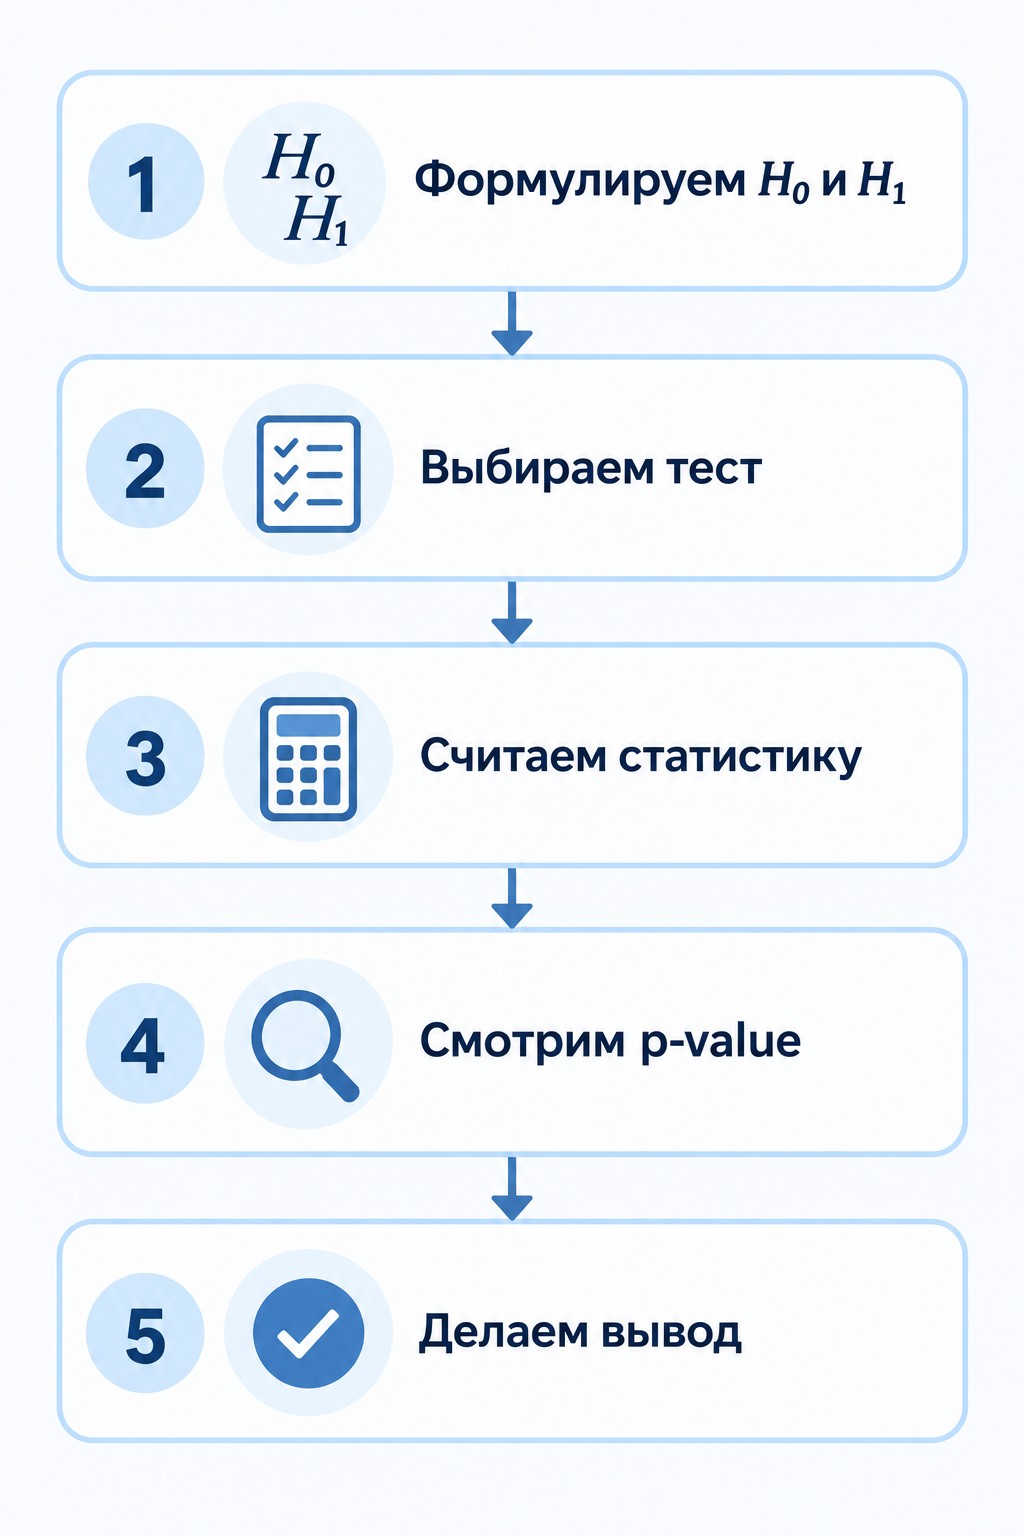
Алгоритм проверки статистических гипотез:
Помимо ошибки I рода (α — отвергли истинную H0), есть ошибка II рода (β — не отвергли ложную H0). Мощность теста = 1 − β: вероятность обнаружить реальный эффект.
P-value — вероятность получить такие или более экстремальные данные при условии истинности H0. Главная ошибка интерпретации: p-value — не вероятность истинности H0. Малое p говорит лишь о несовместимости данных с H0, но ничего не говорит о размере эффекта.
Доверительный интервал (CI) — диапазон правдоподобных значений параметра. «Конверсия 3,5%, 95% CI = [3,1%; 3,9%]» информативнее, чем просто «p = 0,03»: виден и факт эффекта, и его диапазон.
Размер эффекта: статистически значимый результат — не обязательно бизнес-ценный. Конверсия выросла на 0,1 п.п. при p = 0,03? Тест зафиксировал эффект, но стоит ли он затрат на раскатку? Размер эффекта и CI вместе дают ответ на этот вопрос.
Пора сменить профессию? Начните с понятного плана
Подберите программу под ваш опыт, цели и желаемый формат занятости

A/B-тест — контролируемый рандомизированный эксперимент: аудитория случайно делится на группы, каждая получает свой вариант, результат сравнивается статистически. Это прямое применение проверки гипотез в продуктовой и маркетинговой аналитике.
Базовое правило: для пропорций (конверсия, кликабельность) применяется z-тест, для средних (чек, время сессии) — t-тест. Ключевой шаг до запуска — расчёт необходимого объёма выборки через анализ мощности (power analysis): без него тест может остановиться раньше, чем наберёт статистически надёжный результат.
Корреляция — статистическая мера связи между двумя переменными, от −1 до +1. Ключевое правило: корреляция не доказывает причинность. Это одно из самых распространённых заблуждений в корреляционном анализе.
Два основных коэффициента:
Пирсон — измеряет линейную связь. Применяется, когда данные нормально распределены и нет сильных выбросов.
Спирмен — ранговая корреляция: сравниваются не сами значения, а их ранги. Подходит при скошенных распределениях, выбросах, порядковых данных или малой выборке.
Правило выбора: данные нормальные и без выбросов — Пирсон; есть сомнения или данные порядковые — Спирмен.
Классический пример: продажи мороженого коррелируют с числом утоплений. Оба показателя растут летом из-за жары — жара выступает общей причиной (конфаундером). Мороженое здесь ни при чём.
Как установить причинность: рандомизированный A/B-тест (случайное распределение устраняет конфаундеры) или квазиэксперименты — например, метод разности разностей (diff-in-diff), когда рандомизация невозможна. При работе с данными всегда ищите третью переменную, способную объяснить оба показателя.
Параметрические тесты — t-тест, дисперсионный анализ (ANOVA), корреляция Пирсона — предполагают нормальное распределение данных. Они мощнее при соблюдении допущений, но дают ненадёжные результаты при их нарушении.
Непараметрические методы (Манна-Уитни, Краскела-Уоллиса, Спирмен) работают с рангами и не требуют нормальности. Выбирайте их при малой выборке (n < 30), сильной скошенности, большом числе выбросов или порядковых данных.
| Задача |
Параметрический метод |
Непараметрический метод |
|---|---|---|
| Сравнить 2 независимые группы | T-тест | Критерий Манна-Уитни |
| Сравнить 3+ независимые группы | ANOVA | Критерий Краскела-Уоллиса |
| Измерить линейную связь | Корреляция Пирсона | Корреляция Спирмена |
| Сравнить связанные группы (до/после) | Парный t-тест | Критерий Вилкоксона |
| Анализ категориальных переменных | — | Критерий хи-квадрат (χ²) |
Критерии выбора непараметрического: выборка меньше 30, распределение сильно скошено, много выбросов, данные порядковые.
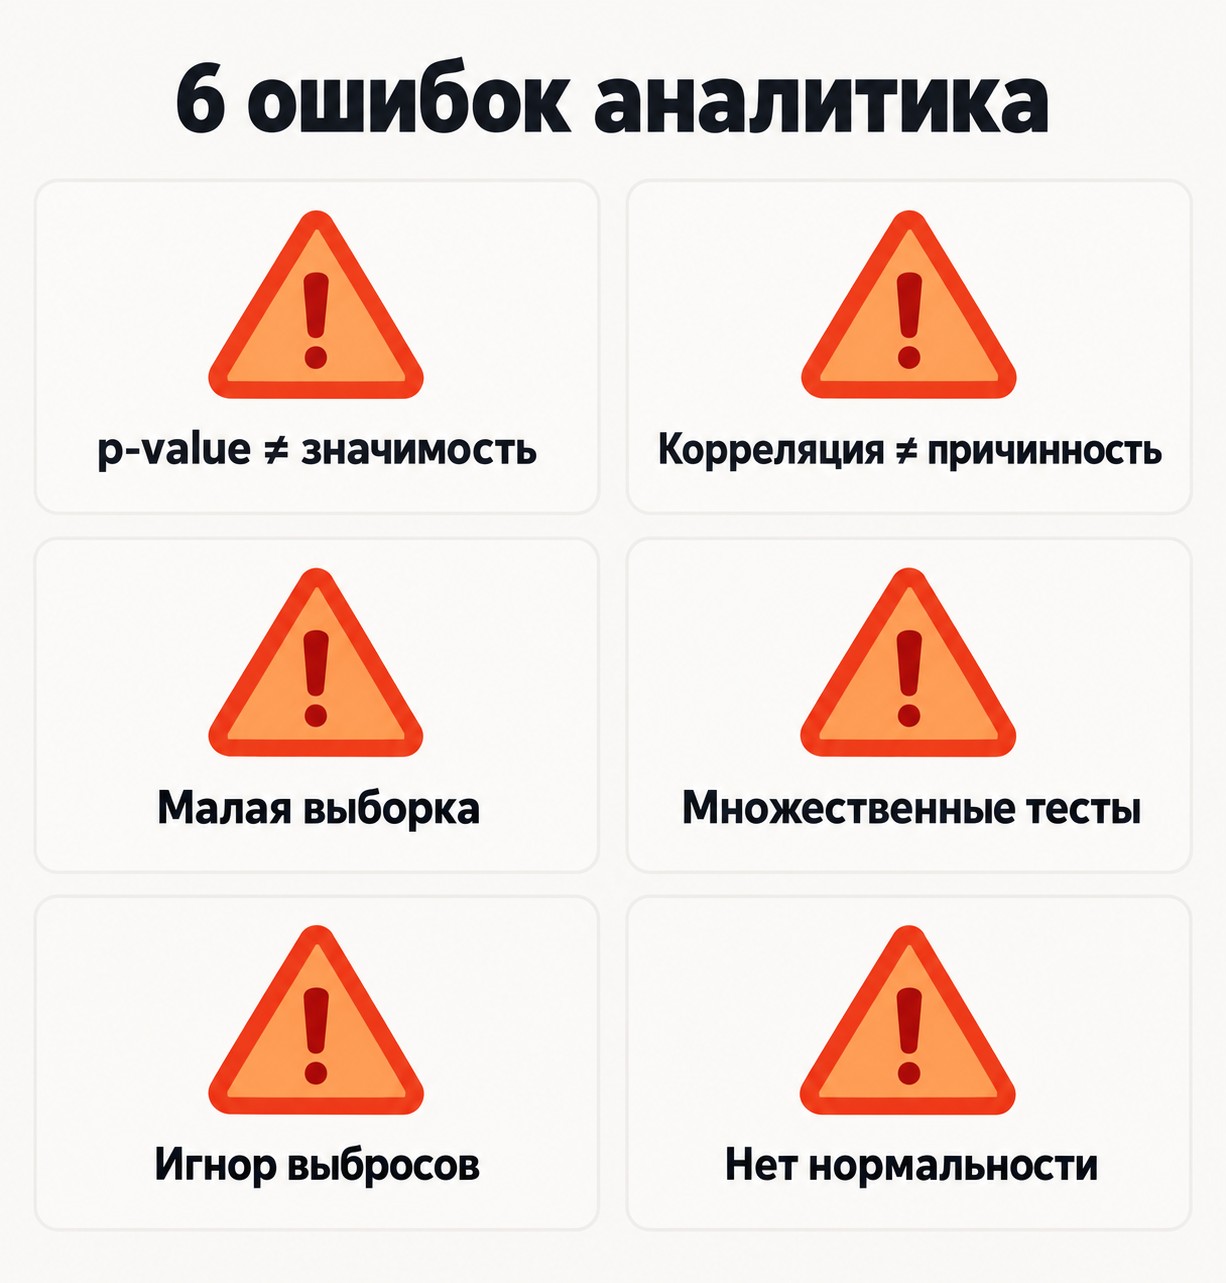
Шесть ошибок, которые повторяются в реальной работе со статистическими данными:
Ошибка 1: сразу к тестам без EDA. Пропущенные значения, выбросы и неправильный тип данных искажают результаты тестов. Сначала — разведочный анализ.
Ошибка 2: опираться только на среднее. При скошенных данных среднее вводит в заблуждение. Смотрите на медиану и разброс вместе.
Ошибка 3: автоматически удалять выбросы. Выброс — сигнал, а не мусор. Сначала разберитесь: ошибка ввода или реальное событие?
Ошибка 4: принимать корреляцию за причинность. Две переменные связаны — не значит, что одна влияет на другую.
Ошибка 5: смотреть только на p-value. P < 0,05 — не победа. Добавьте размер эффекта и доверительный интервал: только тогда видна практическая ценность результата.
Ошибка 6: обобщать выводы по неполной выборке. Тест проведён на активных пользователях — его результат нельзя автоматически переносить на всю аудиторию.
Четырёхнедельный план:
Инструменты: Excel (функции T.TEST, NORM.DIST) для быстрых расчётов; Python (scipy.stats, statsmodels) для серьёзного анализа и автоматизации. Книги-ориентиры: «Голая статистика» Ч. Уилана — доступное введение без тяжёлых формул; «Trustworthy Online Controlled Experiments» Р. Кохави — про A/B-тесты с позиции практика.
Среднее, медиана, стандартное отклонение, понимание нормального распределения и базовых типов данных. Для middle — добавьте проверку гипотез, A/B-тесты и доверительные интервалы. Senior работает с регрессионным анализом, непараметрическими методами и байесовским подходом.
Нет. Для большинства задач достаточно базовой статистики: распределения, гипотезы, интервалы. Линейная алгебра и математический анализ нужны Data Scientist, который строит и обучает модели. Аналитик работает с интерпретацией данных и обоснованием бизнес-решений.
Excel подходит для быстрых расчётов — функции T.TEST, NORM.DIST. Python (scipy.stats, statsmodels) — для серьёзного анализа: гибкость, автоматизация, большие объёмы данных. На собеседованиях проверяют концепции, а не синтаксис — понимание важнее инструмента.
При скошенных распределениях и наличии выбросов. Если средний чек 2 500 ₽, а медианный — 800 ₽, небольшая доля крупных заказов тянет среднее вверх. Медиана точнее описывает «типичного» клиента.
P-value — вероятность получить такие или более экстремальные данные при условии, что нулевая гипотеза верна. Главная ошибка: это не вероятность истинности H0. Небольшое p-value не говорит о размере или практической значимости эффекта.
Z-тест — для сравнения пропорций (конверсия группы A против B). T-тест — для сравнения средних (чек, время сессии). Оба применимы при n > 30: ЦПТ обеспечивает нормальность распределения средних.
Три способа: гистограмма (форма колокола) и Q-Q plot (точки вдоль прямой); тест Шапиро-Уилка в Python — scipy.stats.shapiro; при n > 30 ЦПТ гарантирует нормальность распределения средних — t-тест применим даже при ненормальных исходных данных.
Статистика — математический инструментарий: методы, формулы, тесты. Аналитика данных — профессиональная деятельность: сбор, обработка, визуализация и интерпретация для бизнес-решений. Статистика — ключевой раздел аналитики, но аналитик также работает с SQL, Python и коммуникацией результатов.
Превратите интерес к теме в новую профессию
Оставьте заявку — поможем выбрать программу и расскажем об условиях обучения
Оставить заявку


 Задать вопрос


 Задать вопрос