Регрессионный тест прошёл, UI говорит «Оплачено» — а в базе данных две записи вместо одной. Деньги списаны дважды. Баг обнаружила поддержка клиентов через неделю. SQL для тестировщика — инструмент, позволяющий заглянуть под поверхность интерфейса: один SELECT, и скрытая ловушка видна.
Три сценария, в которых QA-инженер обращается к SQL: верификация данных после операции, подготовка тестовых данных (один INSERT заменяет день ручного заполнения форм), диагностика бага — выяснить, проблема в данных, API или UI. Семь тем ниже закрывают 90% вопросов на QA-собеседовании.

Сделайте следующий шаг в карьере
Подберите обучение, которое поможет освоить новые компетенции
| Тема |
Уровень |
Частота на собеседованиях |
|---|---|---|
| SELECT и WHERE | Junior | Почти всегда |
| JOIN | Junior / Middle | 80% собеседований |
| Агрегатные функции | Junior / Middle | Часто |
| GROUP BY и HAVING | Middle | Часто |
| Подзапросы | Middle | Регулярно |
| Порядок выполнения SQL | Middle | Регулярно |
| NULL-семантика | Junior / Middle | Часто |
Все примеры в статье работают с двумя таблицами: users (id, name, email, age, city, phone) и orders (id, user_id, amount, status, created_at).
Тестирование баз данных — не отдельная дисциплина, а естественная часть работы QA-инженера. Баги в данных существуют независимо от того, видны они через интерфейс или нет.
Сценарий 1: верификация данных. Пользователь нажал «Оплатить», API вернул 200 OK, экран показывает «Оплачен». Но правильно ли записано в таблице payments? Прямой запрос к базе отвечает за секунду:
SELECT * FROM payments WHERE order_id = 1234;
Если записей две — баг двойного списания зафиксирован. Без SQL этот дефект останется незамеченным.
Сценарий 2: подготовка тестовых данных. Вместо регистрации 100 тестовых пользователей через форму весь день — один INSERT:
INSERT INTO users (name, email, age, city)
VALUES (‘Test User 1’, ‘test1@example.com’, 25, ‘Москва’),
(‘Test User 2’, ‘test2@example.com’, 30, ‘СПб’);
Сценарий 3: диагностика бага. Пользователь пишет: «Не вижу свои заказы». Три источника проблемы — UI, API, данные. Один SELECT с JOIN указывает на конкретный слой:
SELECT u.name, o.id AS order_id, o.status
FROM users u
LEFT JOIN orders o ON u.id = o.user_id
WHERE u.email = ‘user@example.com’;
Если запрос возвращает строки с NULL в колонке order_id — проблема в данных: заказы не записаны. Если данные корректны — ищем дальше в API или UI.
SQL (Structured Query Language, язык структурированных запросов) — декларативный язык: вы описываете что хотите получить, а не как это делать. Запросы на выборку данных принято обозначать аббревиатурой DQL (Data Query Language). Они начинаются с ключевого слова SELECT.
SELECT * FROM orders; — все колонки, все строки
SELECT id, amount FROM orders; — только нужные колонки
SELECT DISTINCT city FROM users; — уникальные значения
SELECT * удобен для быстрой проверки. В рабочих запросах лучше указывать конкретные колонки: меньше нагрузки на базу, лучше читаемость.
Сортировка и ограничение выборки — стандартная задача при проверке тарификации:
SELECT id, amount FROM orders
ORDER BY amount DESC
LIMIT 5;
Запрос вернёт пять самых дорогих заказов.
Клауза WHERE фильтрует строки до группировки и агрегации. Основные операторы:
WHERE age > 25
WHERE city IN (‘Москва’, ‘СПб’)
WHERE amount BETWEEN 100 AND 500
WHERE name LIKE ‘An%’
WHERE phone IS NULL
LIKE — инструмент поиска по шаблону строки. Три варианта использования:
| Шаблон |
Что означает |
Пример |
|---|---|---|
| % | Любое количество символов (включая ноль) | LIKE ‘%gmail%’ — email содержит «gmail» |
| _ | Ровно один произвольный символ | LIKE ‘_va’ — «Ева», «Ова», «Два» |
| text% | Начинается с «text» | LIKE ‘An%’ — «Anna», «Andrei» |
| %text | Заканчивается на «text» | LIKE ‘%.ru’ — домены .ru |
Критический момент: WHERE phone = NULL не работает. NULL — маркер отсутствия значения, не пустая строка и не ноль. Любое сравнение через = с NULL возвращает NULL, а не TRUE. Правильный вариант — IS NULL или IS NOT NULL.
JOIN объединяет данные из двух таблиц по условию — как правило, по первичному (PRIMARY KEY) и внешнему (FOREIGN KEY) ключам в реляционной базе данных. Эта тема встречается на 80% QA-собеседований: именно JOIN позволяет находить нарушения целостности данных.
Представьте: в orders есть заказ с user_id = 99, но пользователя с таким id в users нет. «Осиротевшая» запись (orphaned record) — типичный дефект целостности. JOIN помогает его обнаружить:
SELECT o.id, o.user_id
FROM orders o
LEFT JOIN users u ON o.user_id = u.id
WHERE u.id IS NULL;
| Тип |
Формула |
Что возвращает |
NULL в результате |
|---|---|---|---|
| INNER JOIN | A ∩ B | Только совпадающие строки из обеих таблиц | Нет |
| LEFT JOIN | A + (A ∩ B) | Все строки левой таблицы + совпадения из правой | Да, в колонках правой таблицы |
| RIGHT JOIN | B + (A ∩ B) | Все строки правой таблицы + совпадения из левой | Да, в колонках левой таблицы |
| FULL JOIN | A ∪ B | Все строки из обеих таблиц | Да, с обеих сторон |
Два редких типа, которые спрашивают на Middle: SELF JOIN — таблица объединяется сама с собой через псевдоним (когда строки связаны между собой, например сотрудник и его менеджер в одной таблице employees). CROSS JOIN — декартово произведение: каждая строка первой таблицы комбинируется с каждой строкой второй.
QA-специфика: тестировщики чаще применяют LEFT JOIN, а не INNER — он сохраняет все записи основной таблицы и показывает, где данные отсутствуют.
Классика QA-собеседования: найти всех пользователей, у которых нет ни одного заказа.
SELECT u.id, u.name, u.email
FROM users u
LEFT JOIN orders o ON u.id = o.user_id
WHERE o.id IS NULL;
Почему LEFT, а не INNER JOIN? INNER вернул бы только пользователей с заказами — и мы потеряли бы именно тех, кого ищем. LEFT JOIN сохраняет всех из users, а WHERE o.id IS NULL фильтрует тех, у кого нет соответствия в orders.
QA-контекст: такой запрос проверяет целостность регистрации — все ли зарегистрированные пользователи корректно создаются в системе и могут совершать покупки.
Агрегатные функции вычисляют значение по набору строк и возвращают одно число. Их ключевая особенность — поведение с NULL:
| Функция |
Что считает |
Поведение с NULL |
Пример |
|---|---|---|---|
| COUNT(*) | Все строки таблицы | NULL включается | 5 строк → COUNT(*) = 5 |
| COUNT(col) | Строки с non-NULL значением | NULL пропускается | 5 строк, 2 NULL → COUNT(phone) = 3 |
| SUM(col) | Сумму значений | NULL пропускается | NULL не влияет на сумму остальных |
| AVG(col) | Среднее значение | NULL не учитывается в знаменателе | Среднее вычисляется только по non-NULL строкам |
| MAX / MIN(col) | Максимум / минимум | NULL пропускается | Не участвует в сравнении |
Ловушка с COUNT — одна из самых частых на собеседованиях. Если в таблице 5 пользователей, но у двух не заполнен телефон: COUNT(*) вернёт 5, COUNT(phone) — 3. Правильный выбор зависит от задачи. QA должен понимать разницу и делать выбор осознанно.
GROUP BY объединяет строки с одинаковыми значениями в группы и применяет агрегатные функции к каждой группе. HAVING фильтрует уже сгруппированные данные — в отличие от WHERE, которая фильтрует строки до группировки.
Последовательность: WHERE убирает ненужные строки → GROUP BY формирует группы → HAVING отбирает нужные группы.
Задача: найти пользователей, потративших более 10 000 ₽.
SELECT u.name, SUM(o.amount) AS total_spent
FROM users u
JOIN orders o ON u.id = o.user_id
GROUP BY u.id, u.name
HAVING SUM(o.amount) > 10000
ORDER BY total_spent DESC;
Почему SUM нельзя в WHERE? Агрегатные функции вычисляются после GROUP BY — это шаг 5 в порядке выполнения SQL, а WHERE — шаг 3. К моменту фильтрации в WHERE группы ещё не созданы, счётчики не вычислены.
Подзапрос (вложенный запрос) — это SELECT внутри другого SELECT. Он выполняется первым, результат передаётся во внешний запрос.
Скалярный подзапрос возвращает одно значение. Пример — найти пользователей старше среднего возраста:
SELECT name, age
FROM users
WHERE age > (SELECT AVG(age) FROM users);
Пора сменить профессию? Начните с понятного плана
Подберите программу под ваш опыт, цели и желаемый формат занятости

Подзапрос с IN возвращает список значений — пользователи с оплаченными заказами:
SELECT name
FROM users
WHERE id IN (
SELECT DISTINCT user_id FROM orders WHERE status = ‘paid’
);
Два подхода к «заказу с максимальной суммой»:
— Подзапрос: вернёт ВСЕ записи с максимальной суммой
SELECT * FROM orders
WHERE amount = (SELECT MAX(amount) FROM orders);
— ORDER BY + LIMIT: вернёт только ОДНУ запись
SELECT * FROM orders
ORDER BY amount DESC
LIMIT 1;
Если записей с максимальной суммой несколько — подходы дают разный результат. Умение объяснить эту разницу на собеседовании отделяет Junior от Middle.
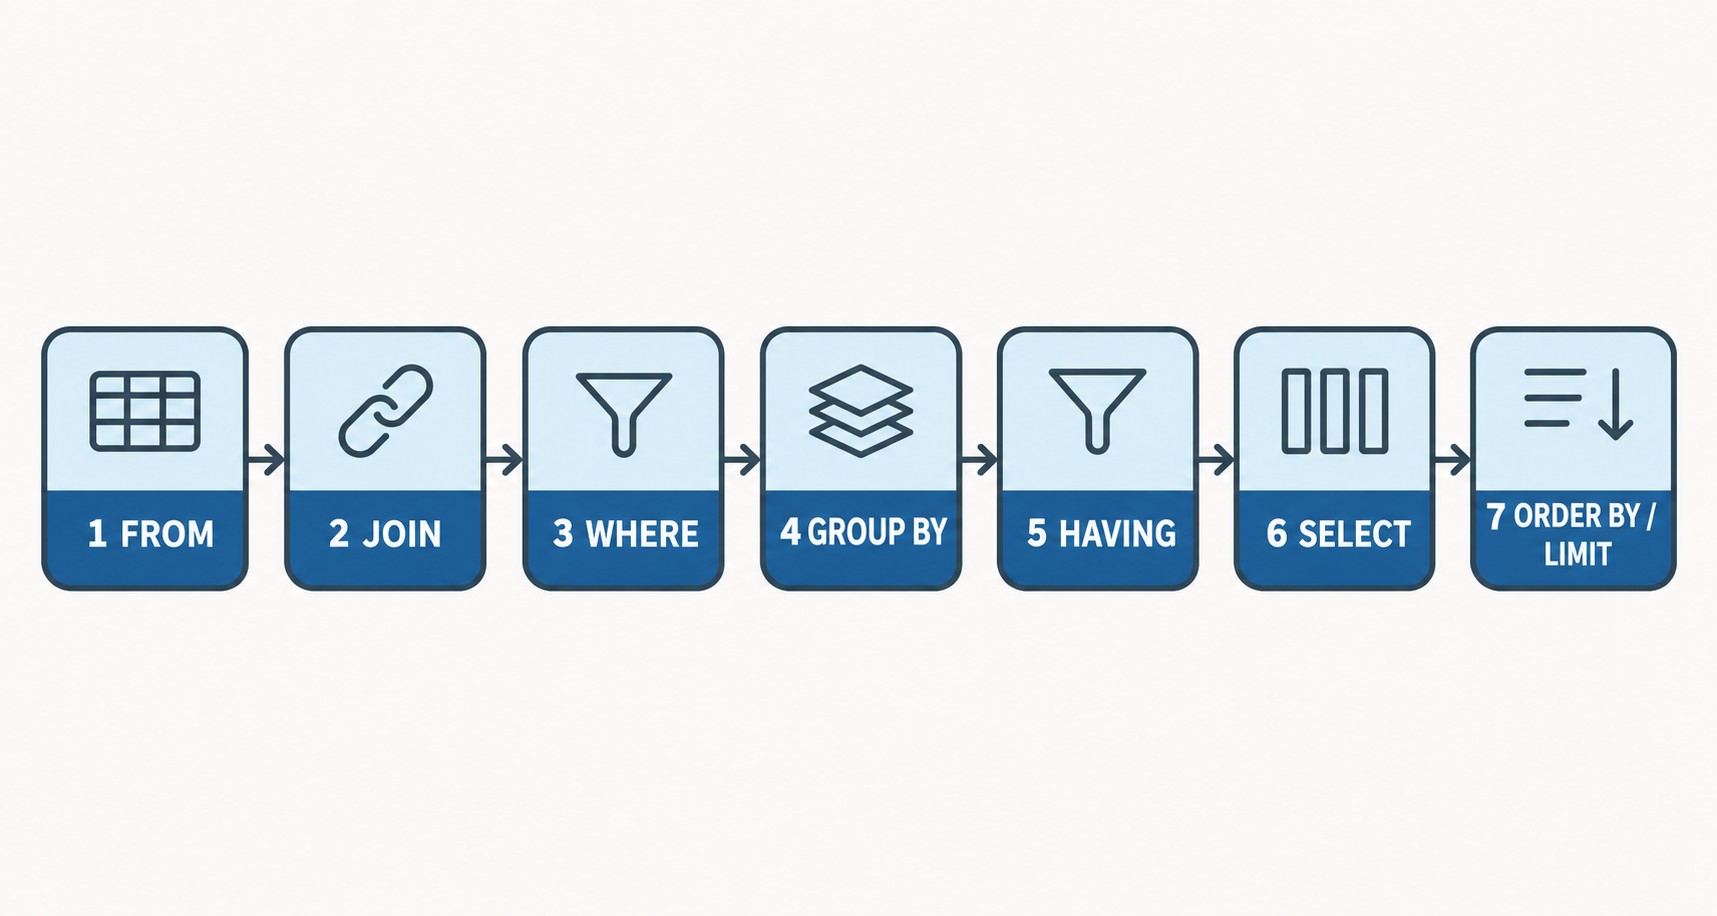
Текст запроса читается слева направо, но СУБД (система управления базами данных) выполняет его иначе. Порядок фиксированный, и от его понимания зависит, какие ошибки вы допустите:
FROM(1) → JOIN(2) → WHERE(3) → GROUP BY(4) → HAVING(5) → SELECT(6) → ORDER BY / LIMIT(7)
Три практических следствия:
Код-ловушка с псевдонимом (алиасом):
— Ошибка: cnt — алиас из SELECT, WHERE не видит его
SELECT user_id, COUNT(*) AS cnt
FROM orders
WHERE cnt > 1 — ❌
GROUP BY user_id;
— Правильно: фильтр сгруппированных данных через HAVING
SELECT user_id, COUNT(*) AS cnt
FROM orders
GROUP BY user_id
HAVING COUNT(*) > 1; — ✅
Знание синтаксиса — одно, понимание семантики SQL — другое. Пять ошибок, которые воспроизводят даже опытные кандидаты:
| Ловушка |
Неправильно |
Правильно |
Причина |
|---|---|---|---|
| NULL-с | Ловушка | Неправильно | Правильно |
| — | — | — | — |
| NULL-сравнение | WHERE city = NULL | WHERE city IS NULL | NULL — маркер; = NULL возвращает NULL, а не TRUE |
| COUNT(*) вместо COUNT(col) | COUNT(*) для подсчёта непустых значений | COUNT(phone) | COUNT(*) включает строки с NULL |
| Не все поля в GROUP BY | SELECT name, city, COUNT(*) → GROUP BY city | GROUP BY city, name | Все не-агрегатные поля должны быть в GROUP BY |
| WHERE вместо HAVING | WHERE COUNT(*) > 1 | HAVING COUNT(*) > 1 | Агрегаты вычисляются после WHERE |
| Алиас в WHERE | WHERE cnt > 1 (cnt — алиас из SELECT) | HAVING COUNT(*) > 1 | SELECT выполняется позже WHERE |
Ловушка с NULL встречается особенно часто — потому что интуитивно кажется, что = NULL должно работать. Но NULL обозначает «значение неизвестно». Результат любого сравнения с неизвестным — снова неизвестность (NULL), а не FALSE.
Задачи ниже взяты из практики QA-собеседований — Junior и Middle уровни. Все решаются на таблицах users и orders, введённых в начале статьи. Задача Junior: написать рабочий запрос. Задача Middle: написать и объяснить выбор каждого инструмента.
| Задача |
Концепт |
SQL-код |
|---|---|---|
| Пользователи без заказов | LEFT JOIN + IS NULL | SELECT u.name FROM users u LEFT JOIN orders o ON u.id = o.user_id WHERE o.id IS NULL |
| Топ-3 покупателя по сумме | JOIN + SUM + ORDER BY + LIMIT | SELECT u.name, SUM(o.amount) AS total FROM users u JOIN orders o ON u.id = o.user_id GROUP BY u.id, u.name ORDER BY total DESC LIMIT 3 |
| Дублирующиеся email | GROUP BY + HAVING | SELECT email, COUNT(*) AS cnt FROM users GROUP BY email HAVING COUNT(*) > 1 |
| Второй по величине заказ | DISTINCT + OFFSET | SELECT DISTINCT amount FROM orders ORDER BY amount DESC LIMIT 1 OFFSET 1 |
| Пользователи старше среднего | Скалярный подзапрос | SELECT name, age FROM users WHERE age > (SELECT AVG(age) FROM users) |
Каждая задача привязана к реальному QA-сценарию: проверка целостности регистрации, верификация тарификации, поиск дублей в пользовательских данных.
Задача 1: кто потратил больше 10 000 ₽?
SELECT u.name, SUM(o.amount) AS total_spent
FROM users u
JOIN orders o ON u.id = o.user_id
GROUP BY u.id, u.name
HAVING SUM(o.amount) > 10000
ORDER BY total_spent DESC;
Почему SUM в HAVING, а не в WHERE — разобрано в разделе про порядок выполнения.
Задача 2: конверсия по городам
SELECT
u.city,
COUNT(DISTINCT u.id) AS total_users,
COUNT(DISTINCT o.user_id) AS users_with_orders,
ROUND(COUNT(DISTINCT o.user_id) * 100.0 / COUNT(DISTINCT u.id), 1) AS conversion_pct
FROM users u
LEFT JOIN orders o ON u.id = o.user_id
GROUP BY u.city;
Три нюанса: COUNT(DISTINCT u.id) — уникальные пользователи; 100.0 вместо 100 — для дробного деления; LEFT JOIN — иначе потеряем города без заказов. Middle-кандидат объясняет каждый элемент, а не просто воспроизводит код.
| Ресурс |
Формат |
Уровень |
Цена |
Дифференциатор |
|---|---|---|---|---|
| Тестировщик программного обеспечения (ProfiFuture) | Онлайн, 7 недель | С нуля | 29 900 ₽ со скидкой | SQL в составе полной программы QA; господдержка — 75% стоимости покрывается образовательной квотой |
| SQLBolt | Интерактивные уроки в браузере | Начинающий→средний | Бесплатно | 15 минут в день, без установки ПО |
| LeetCode (SQL) | Практические задачи | Easy→Hard | Базовый уровень — бесплатно | Задачи с реальных технических собеседований |
| w3resource | Упражнения с проверкой | Любой | Бесплатно | Мгновенная проверка решения онлайн |
Практический совет: установите PostgreSQL локально, создайте таблицы users и orders с тестовыми данными и решайте задачи руками. Прочитанный SQL усваивается в разы хуже написанного.
Да. QA-инженер без SQL видит только вершину айсберга: баги с дублированием записей или нарушением целостности данных невидимы через интерфейс. SQL позволяет обратиться к базе напрямую. Для Junior достаточно SELECT + WHERE + JOIN + IS NULL; для Middle — GROUP BY, подзапросы и понимание порядка выполнения.
SQL расшифровывается как Structured Query Language — язык структурированных запросов. Создан IBM в 1974 году (Дональд Чемберлин и Раймонд Бойс), стандартизирован ANSI/ISO в 1986 году. Декларативный язык для работы с реляционными базами данных: выборка, вставка, обновление и удаление данных.
Синтаксис SQL — правила написания запросов. SELECT идёт первым в тексте, но выполняется шестым. Нарушение логического порядка клауз (например, HAVING без GROUP BY) вызывает ошибку. СУБД нечувствительна к регистру ключевых слов, но строго соблюдает порядок: FROM → JOIN → WHERE → GROUP BY → HAVING → SELECT → ORDER BY / LIMIT.
COUNT() считает все строки таблицы, включая строки с NULL. COUNT(column) считает только строки, где значение column не равно NULL. Пример: таблица с 5 пользователями, у 2 не указан телефон — COUNT() = 5, COUNT(phone) = 3. Выбор зависит от задачи; на собеседованиях это ловушка №2.
NULL — маркер отсутствия значения, не пустая строка и не ноль. Любое сравнение через «=» с NULL возвращает NULL, а не TRUE. Правильный оператор: IS NULL или IS NOT NULL. Это ловушка №1 на QA-собеседованиях — ошибку допускают даже кандидаты с опытом.
WHERE фильтрует строки до группировки и не может содержать агрегатные функции. HAVING фильтрует уже сгруппированные данные после GROUP BY и работает с COUNT, SUM и другими агрегатами. Порядок выполнения: WHERE(шаг 3) → GROUP BY(шаг 4) → HAVING(шаг 5).
Фиксированная последовательность: FROM → JOIN → WHERE → GROUP BY → HAVING → SELECT → ORDER BY / LIMIT. Поэтому алиас из SELECT нельзя использовать в WHERE или GROUP BY — эти клаузы выполняются раньше. Алиас доступен только в ORDER BY. Агрегаты вычисляются в HAVING, а не в WHERE.
Для Junior: SELECT + WHERE + JOIN + IS NULL + ORDER BY / LIMIT на таблицах users и orders. Решить 5 задач: пользователи без заказов, дубли email, топ покупателей, второй по величине заказ, подзапрос. Для Middle: добавить GROUP BY + HAVING + порядок выполнения + объяснение логики выбора инструментов. JOIN спрашивают в 80% собеседований — начинать именно с него.
Превратите интерес к теме в новую профессию
Оставьте заявку — поможем выбрать программу и расскажем об условиях обучения
Оставить заявку


 Задать вопрос


 Задать вопрос