SQL (Structured Query Language — язык структурированных запросов) — основной рабочий инструмент аналитика данных. Это декларативный язык запросов к реляционным базам данных: вы описываете нужный результат, а система управления базами данных (СУБД) сама определяет способ его получения. По данным hh.ru о навыках ИТ-рынка за 2026 год, SQL для аналитика входит в топ-3 востребованных компетенций. При этом базовый SELECT знают все — реальный дефицит среди специалистов с оконными функциями, CTE и умением строить аналитические запросы. В статье — уровни навыков, SQL для финансового аналитика и подготовка к собеседованию.
SQL создан в 1974 году в IBM, актуальный стандарт — SQL:2023. Декларативность языка — ключевая особенность: аналитик описывает нужную выборку, а СУБД (PostgreSQL, ClickHouse, BigQuery, MySQL) выполняет её сама. Реляционная база данных хранит данные в таблицах, связанных через первичные и внешние ключи.

Сделайте следующий шаг в карьере
Подберите обучение, которое поможет освоить новые компетенции
Главное преимущество перед Excel — масштаб и скорость: SQL обрабатывает миллиарды строк за секунды там, где таблица зависнет или упадёт. Запросы автоматизируются, результаты воспроизводятся без ручной работы. Простейший пример — выборка пользователей из Москвы:
SELECT user_id, country
FROM users
WHERE city = ‘Москва’;
Для подключения к базе аналитики используют DBeaver или командную строку — СУБД выступает посредником между запросом и физическими данными на диске.
SQL-компетенции делятся на три уровня: Джун, Мидл, Сениор. Переход между ними определяется не временем в профессии, а конкретными инструментами в арсенале — каждый уровень открывает новый класс задач. Подробнее о самой профессии — в материале о карьере аналитика данных.
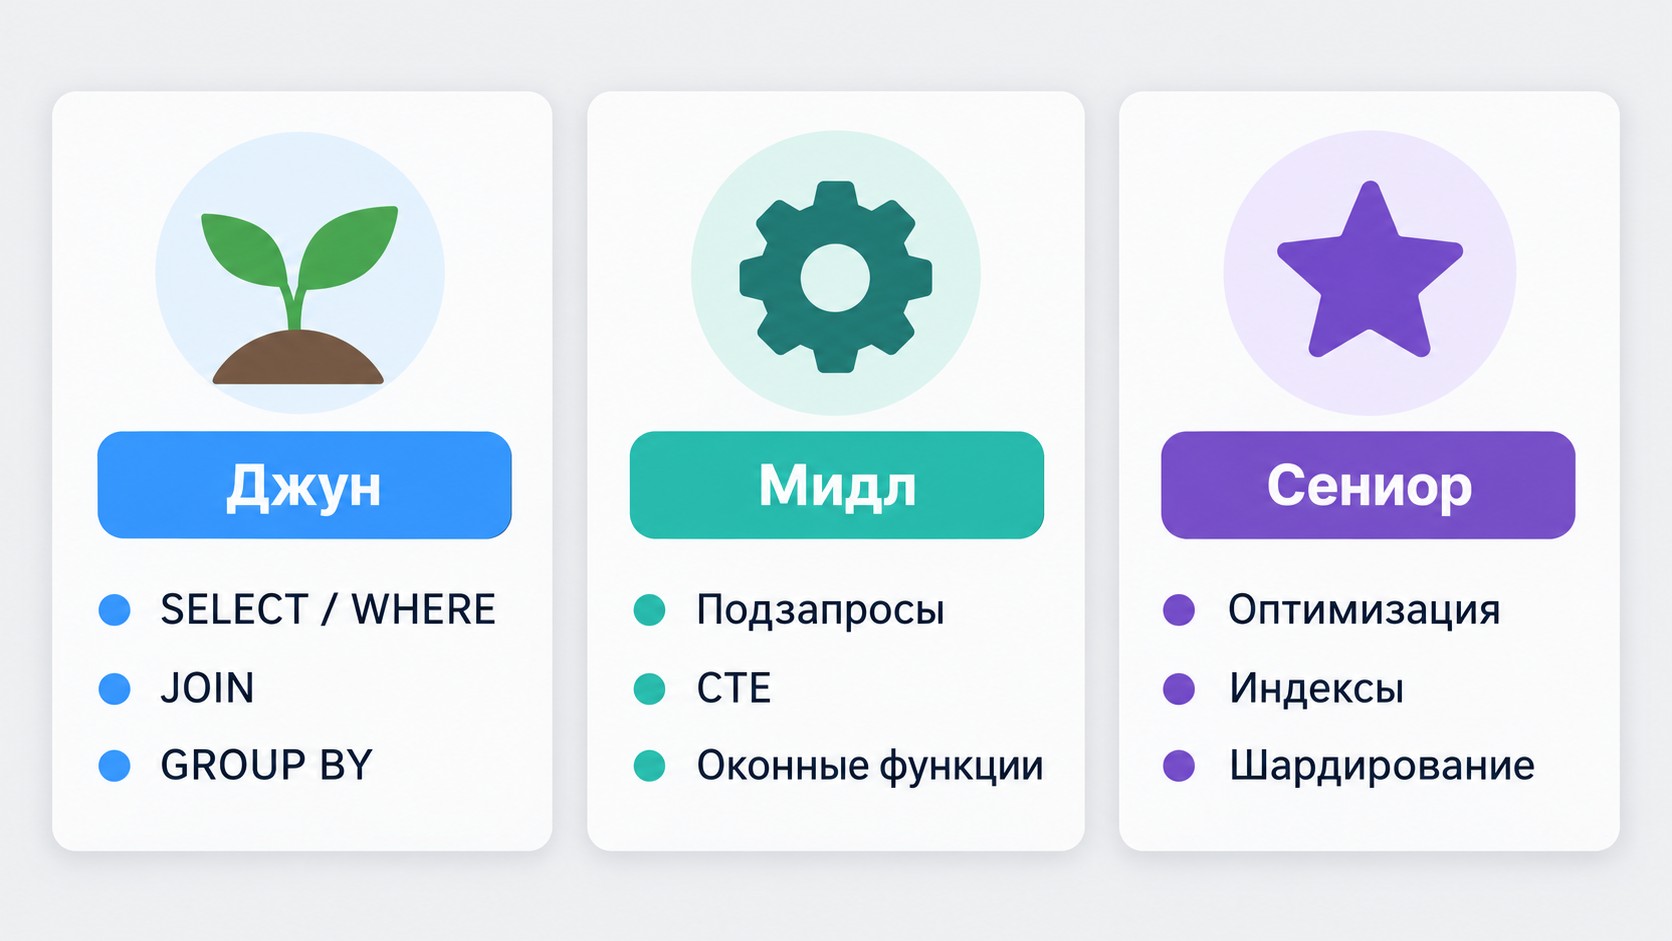
Джун-аналитик работает с пятью базовыми блоками: SELECT / WHERE / ORDER BY / LIMIT / DISTINCT — выборка с фильтрацией и сортировкой; GROUP BY + агрегатные функции COUNT, SUM, AVG — первая аналитика; INNER JOIN и LEFT JOIN — соединение нескольких таблиц.
Отдельная тема — типы данных: INT, VARCHAR, DATE, TIMESTAMP. Ошибки с типами ломают запросы ещё до группировки.
Принципиальный момент: WHERE фильтрует строки до группировки и не видит агрегатных функций. HAVING — фильтрует готовые группы после GROUP BY. Типичная ошибка: WHERE COUNT(*) > 100 — синтаксически неверно; правильно — HAVING COUNT(*) > 100. Чтобы отсортировать по дате — ORDER BY date DESC: ORDER BY выполняется ближе к концу цепочки запроса и поэтому недоступен в WHERE.
Главный переход Джун→Мидл — оконные функции. В отличие от GROUP BY, они не схлопывают строки в результате: каждая строка остаётся, рядом добавляется вычисленное значение.
CTE (обобщённое табличное выражение, WITH имя AS (подзапрос)) — конструкция для многошаговых запросов. Читается сверху вниз как шаги алгоритма и упрощает отладку. CTE решает ключевое ограничение оконных функций: их нельзя применять напрямую в WHERE или HAVING — нужно завернуть результат в CTE и уже к ней применять фильтр.
NULL в SQL — «неизвестное значение»: не ноль и не пустая строка. Сравнение = NULL не работает, только IS NULL. Ловушка: NOT IN (подзапрос) с NULL в подзапросе возвращает пустой результат — безопасная замена NOT EXISTS.
Оконные функции работают по синтаксису OVER(PARTITION BY … ORDER BY …). PARTITION BY делит строки на группы-«окна»; ORDER BY задаёт порядок внутри окна для ранжирования или накопления. Ключевое отличие от GROUP BY — детализация сохраняется, строки не схлопываются. Ограничение: результат нельзя фильтровать в WHERE — нужен CTE.
Если хотите освоить оконные функции и когортный анализ на реальных бизнес-данных — посмотрите программу Data-аналитик: Python и SQL в анализе данных от ProfiFuture: около 8 недель обучения с господдержкой 75%.
Ранжирование — три функции с разным поведением при одинаковых значениях:
| Функция |
Поведение при ничьей |
Пример: позиции |
|---|---|---|
| ROW_NUMBER() | Уникальный номер всегда | 1, 2, 3, 4 |
| RANK() | Пропускает номера после ничьей | 1, 2, 2, 4 |
| DENSE_RANK() | Не пропускает номера | 1, 2, 2, 3 |
Смещение — LAG() возвращает значение предыдущей строки, LEAD() — следующей. Применение: прирост выручки день к дню без самосоединения таблицы:
LAG(revenue) OVER (ORDER BY date) AS prev_revenue
Агрегирование — SUM() OVER(ORDER BY date) даёт накопительный итог; AVG() OVER(… ROWS BETWEEN 6 PRECEDING AND CURRENT ROW) — скользящее среднее за 7 дней.
JOIN соединяет таблицы по условию. INNER — только совпадения; LEFT — все строки левой таблицы и NULL справа при отсутствии совпадения; FULL — все строки обеих таблиц; CROSS — декартово произведение. Типичная ошибка — пропущенный ON: строк в результате резко больше ожидаемого. NULL обрабатывается особо: COALESCE(поле, 0) заменяет NULL на значение по умолчанию, NULLIF(знаменатель, 0) защищает от деления на ноль.
| Параметр |
GROUP BY |
Оконные функции |
|---|---|---|
| Строки в результате | Схлопывает в N групп | Сохраняет все строки |
| Детализация | Теряется | Сохраняется |
| Использование в WHERE | Да | Нет — только через CTE |
| Типичная задача | Итоги по категориям | Ранжирование, накопитель, LAG |
Порядок выполнения запроса: FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT. Именно поэтому алиас, объявленный в SELECT, недоступен в WHERE — он создаётся позже. Первичный ключ уникально идентифицирует строку таблицы; внешний ключ ссылается на первичный ключ другой — основа любого JOIN.
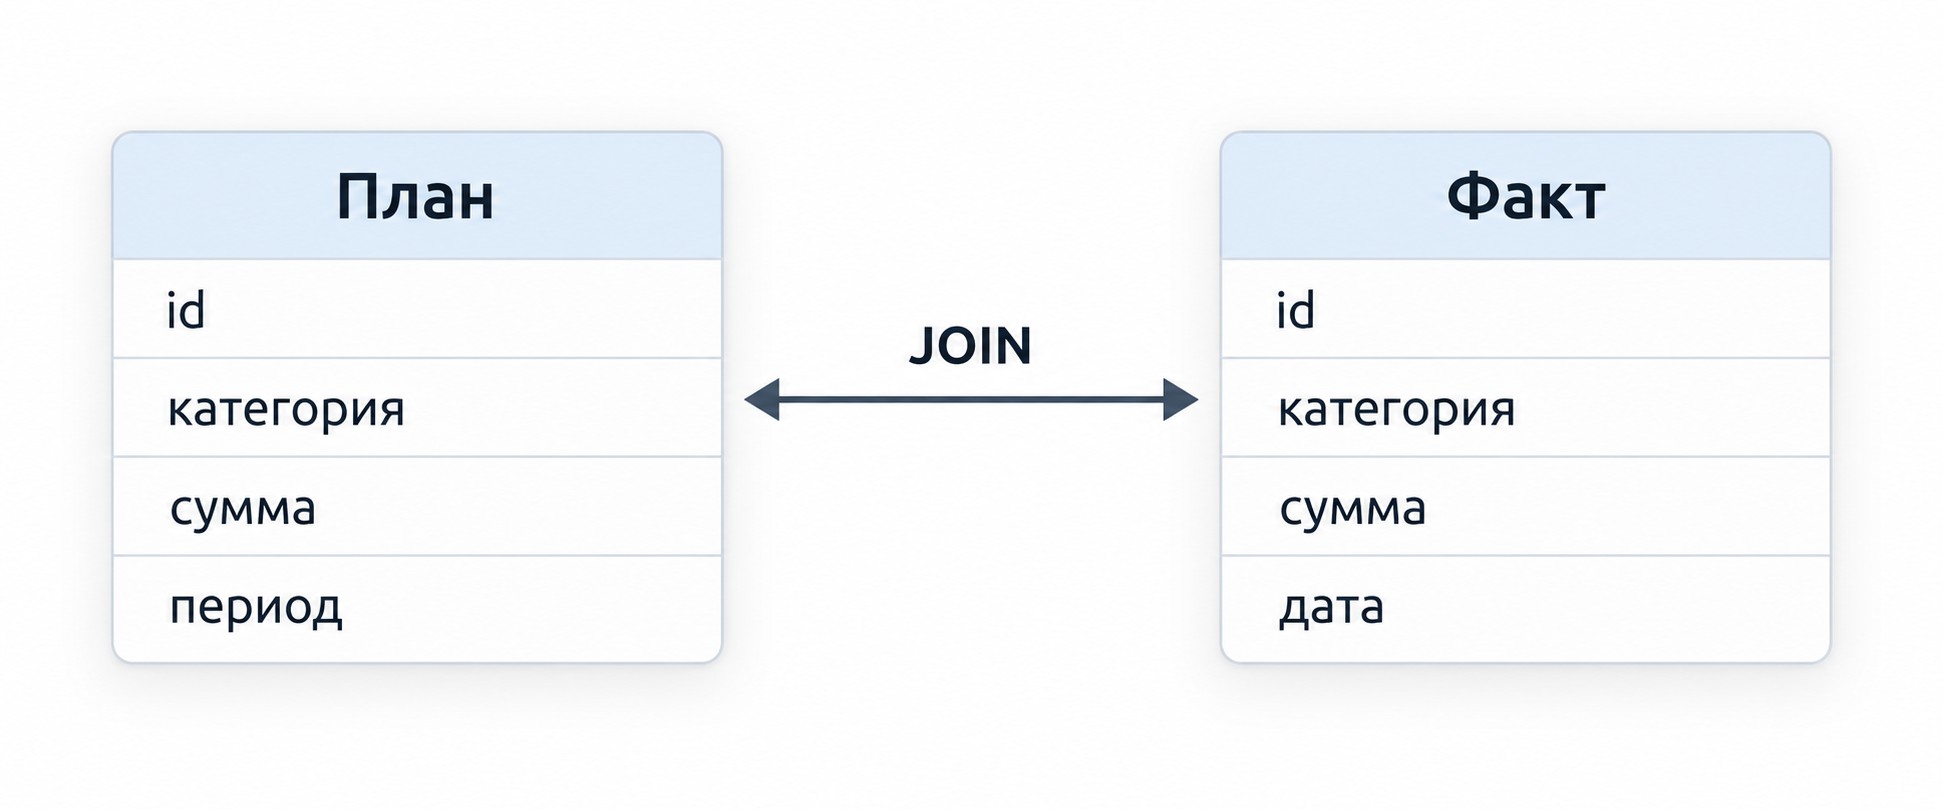
Финансовый аналитик решает другой класс задач: P&L (отчёт о прибылях и убытках), сравнение план/факт, анализ дебиторской задолженности, динамика бюджета по периодам. Эта специализация практически не встречается в стандартных SQL-материалах.
Пять типовых SQL-паттернов финансиста:
Связка LAG() + DATE_TRUNC — ключевой паттерн для анализа финансовых данных на SQL в любой временно́й задаче.
Пора сменить профессию? Начните с понятного плана
Подберите программу под ваш опыт, цели и желаемый формат занятости

Собеседование по SQL для аналитика проходит в трёх форматах: теоретические вопросы, задачи вживую в редакторе и разбор чужого кода с поиском ошибок. Уровень кандидата проверяется разными темами — Джун, Мидл и Сениор получают принципиально разные вопросы.
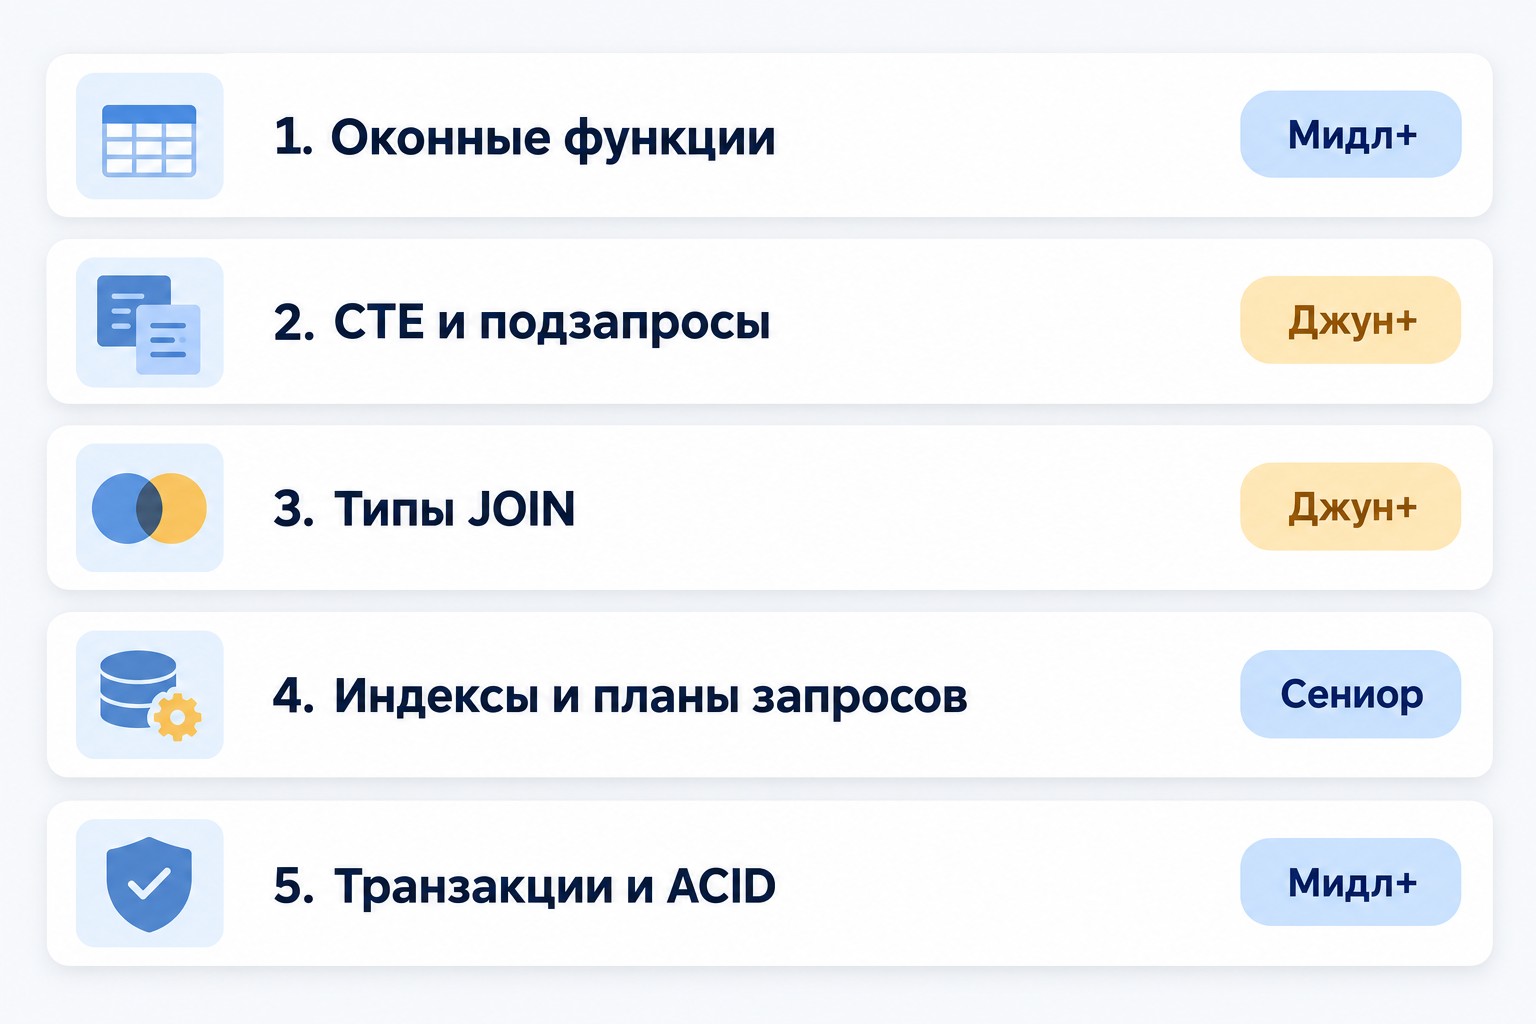
Джун: WHERE vs HAVING, INNER vs LEFT JOIN, зачем DISTINCT.
Мидл: RANK vs ROW_NUMBER vs DENSE_RANK, NULL в NOT IN, когортный анализ с расчётом Retention Rate.
Сениор: EXPLAIN / EXPLAIN ANALYZE, индексы, чтение плана запроса.
Три классические задачи по SQL для собеседования аналитика:
Когортный анализ — классическое тестовое задание для мидл-уровня на SQL-собеседовании. Разбирайте паттерн заранее, не на самом интервью.
Пять ошибок, которые стоят офферов:
| Ресурс |
Тип |
Уровень |
Бесплатно |
Диалект |
|---|---|---|---|---|
| Stepik «Интерактивный тренажёр по SQL» | Тренажёр | Джун | Да | PostgreSQL |
| SQL Academy | Тренажёр | Джун–Мидл | Да | PostgreSQL |
| LearnSQL.com | Тренажёр | Джун–Мидл | Частично | PostgreSQL/MySQL |
| «Learning SQL» О’Рейли | Книга | Джун–Мидл | Нет | PostgreSQL |
| Официальная документация PostgreSQL | Документация | Мидл–Сениор | Да | PostgreSQL |
Диалект для старта — PostgreSQL: максимально близок к стандарту ANSI SQL, широко применяется в аналитике. После его освоения 90% знаний переносится в ClickHouse (OLAP-задачи для крупных аналитических хранилищ) и BigQuery (Google Cloud — здесь плата за прочитанные данные меняет культуру написания запросов). Не распыляйтесь на несколько диалектов одновременно.
Главный принцип: SQL для аналитика усваивается только через практику на реальных данных, а не через чтение теории. Если рядом с SQL в вашем стеке стоит Excel — полезно изучить и Excel для аналитика данных.
Базовый набор: SELECT, WHERE, ORDER BY, LIMIT, DISTINCT — выборка с фильтрацией. GROUP BY + COUNT/SUM/AVG — агрегация. INNER JOIN и LEFT JOIN — соединение таблиц. HAVING — фильтрация по агрегатам. Этот набор покрывает около 80% задач джун-аналитика: выгрузки, сегментация клиентов, отчёты по продажам. Ошибки с типами данных (INT vs VARCHAR, DATE vs TIMESTAMP) разбирайте с первых занятий.
GROUP BY схлопывает группу строк в одну — детализация теряется. Оконная функция вычисляет значение по «окну» строк и сохраняет все исходные строки. ROW_NUMBER(), SUM() OVER, LAG() работают без уменьшения числа строк в результате. Накопительный итог, ранжирование внутри группы или прирост день/день требуют именно оконных функций, а не GROUP BY.
WHERE фильтрует строки до группировки и не работает с агрегатами. HAVING фильтрует готовые группы после GROUP BY и применяется к агрегатным функциям — COUNT(*), SUM(amount). Порядок выполнения: FROM → WHERE → GROUP BY → HAVING. Типичная ошибка: WHERE COUNT(*) > 100 — синтаксически неверно; правильно — HAVING COUNT(*) > 100. Условия на обычные поля — в WHERE, на агрегаты — в HAVING.
NULL означает «неизвестное значение». Любое сравнение с NULL даёт не TRUE и не FALSE, а UNKNOWN. Если подзапрос в NOT IN содержит хотя бы один NULL, условие становится UNKNOWN для всех строк — фильтр не пропускает ни одной строки. Безопасная замена — NOT EXISTS: корректно обрабатывает NULL и возвращает ожидаемый результат.
Три класса: базовые выборки (SELECT + JOIN + агрегация), ранжирование (топ-N через CTE + DENSE_RANK), временные ряды (LAG() для прироста MoM, скользящее среднее через SUM() OVER с рамкой). Для мидл-позиций добавляется когортный анализ — Retention Rate через DATE_TRUNC + LEFT JOIN. Финансовым аналитикам — план vs факт через JOIN с CASE WHEN для флагов.
Когортный анализ группирует пользователей по дате первого события — регистрации или первой покупки. Стандартный SQL-паттерн: DATE_TRUNC для округления дат до недели или месяца → LEFT JOIN для сопоставления периодов когорты → агрегация для расчёта Retention Rate. Результат — матрица «когорта × период» с долей вернувшихся пользователей. Классическое тестовое задание мидл-уровня на SQL-собеседовании.
Начинайте с PostgreSQL: максимально близок к стандарту ANSI SQL, широко применяется в аналитике, хорошо задокументирован. После освоения 90% знаний переносится в MySQL, ClickHouse и BigQuery. ClickHouse изучайте для OLAP-хранилищ с большими объёмами данных, BigQuery — при работе в Google Cloud. Не распыляйтесь на несколько диалектов одновременно — освойте один до уровня мидл.
Ключевые критерии: практика на реальных данных, а не только синтаксис; охват оконных функций и CTE; задачи на когортный анализ. Тренажёры дают синтаксис, полноценные курсы — аналитическое мышление и разбор реальных кейсов. Оптимальный диалект для старта — PostgreSQL. Курс должен включать продвинутые конструкции, а не только базовые SELECT, чтобы подготовить к рынку труда в 2026 году.
Превратите интерес к теме в новую профессию
Оставьте заявку — поможем выбрать программу и расскажем об условиях обучения
Оставить заявку


 Задать вопрос


 Задать вопрос