Два риска преследуют любой бизнес, работающий с товарными запасами. Первый — дефицит: покупатель не находит нужный товар и уходит к конкуренту. Второй — избыток: деньги заморожены в остатках, склад перегружен, а часть товара рискует стать списанием. Оба варианта болезненны для выручки и репутации.
Прогнозирование спроса — системный процесс, который помогает удерживать баланс между этими двумя крайностями. В статье разбираем: что такое прогнозирование спроса, какие методы расчёта существуют, как выбрать подходящий, по каким метрикам оценивать точность и какие инструменты автоматизируют этот процесс.
Сделайте следующий шаг в карьере
Подберите обучение, которое поможет освоить новые компетенции
Прогнозирование спроса — системный процесс оценки будущего объёма потребления товаров или услуг с применением статистических, математических и AI-методов. Результатом становятся базовый прогноз (форкаст, от англ. forecast), план закупок и расчёт страхового запаса.
В цепочке поставок (Supply Chain Management) прогноз занимает первое место: производство, логистика, закупки и бюджет — всё строится на основе ожидаемого спроса. Ошибка здесь мультиплицируется по всей цепочке.
Горизонты прогнозирования:
Прежде чем выбирать метод, важно понять тип спроса. Гладкий спрос — среднее расстояние между продажами менее 1,25 дня: товар продаётся регулярно. Редкий спрос — более 1,25 дня: между покупками проходят дни или недели. Это различие меняет всю логику выбора модели: для редкого спроса точечный прогноз почти всегда даёт большую ошибку.
Важно разграничить смежные понятия. Прогнозирование спроса отличается от прогнозирования продаж: продажи — это фактически совершённые сделки. Если товара не было в наличии, продажи зафиксируют ноль, хотя реальный спрос существовал. Неочищенная история продаж ведёт к систематическому занижению прогноза — один из главных источников ошибок при планировании спроса.
Временны́е ряды — основной формат входных данных: история продаж по каждому SKU, складские остатки, даты акций, lead time (время от заказа до поставки) и сезонный календарь.
Прогноз нужен не только закупщикам. Четыре направления, где он напрямую влияет на финансовый результат:
| Сфера |
Задача |
Результат |
|---|---|---|
| Управление запасами | Определить оптимальный уровень остатков | Снижение дефицита и заморозки капитала |
| Планирование персонала | Рассчитать сезонную нагрузку | Своевременный найм и распределение смен |
| Финансовое планирование | Построить прогноз выручки и затрат | Точный бюджет и оценка ROI акций |
| Маркетинг | Оценить эффект промо-кампаний | Корректный расчёт запасов под акцию |
Применение прогнозирования спроса в бизнесе по направлениям.
Самое критичное направление — управление запасами. Именно здесь ошибка прогноза немедленно конвертируется в финансовые потери.
Дефицит (out-of-stock) — это не просто «товара нет на полке». Клиент, который не нашёл нужную позицию, уходит к конкуренту и нередко не возвращается. Следствие — падение выручки, снижение уровня сервиса, ухудшение репутации.
Избыток работает в другую сторону: деньги заморожены в запасах, растут расходы на хранение, скоропортящиеся категории рискуют списанием. Прогнозирование спроса позволяет рассчитать страховой запас — буфер против неопределённости. Он определяется как квантиль распределения спроса на период lead time при целевом уровне сервиса (например, P90 при LOS 90%). Чем точнее прогноз — тем меньший буфер нужен при том же уровне сервиса.
Ключевые KPI результата: оборачиваемость запасов, уровень сервиса (% позиций без дефицита), доля SKU с out-of-stock.
Прогноз спроса лежит в основе сезонного планирования нагрузки. Зная пик продаж мороженого летом или ёлочных игрушек в декабре, компания заблаговременно нанимает временный персонал и арендует дополнительные мощности — а не реагирует постфактум.
Бюджетирование и финансовое планирование требуют ожидаемых объёмов: прогноз выручки, расчёт денежных потоков, оценка ROI маркетинговых акций — всё это строится от ожидаемого спроса на горизонте от месяца до года. Планирование производства тоже определяется этим показателем: объём выпуска, закупка сырья, загрузка оборудования.
Частая ошибка — думать, что ключ к точному прогнозу только в выборе модели. На практике ошибка чаще связана с неучтёнными факторами или «грязными» входными данными. Даже самый продвинутый алгоритм даст плохой результат, если получит неочищенную историю продаж с аномалиями и пропусками. Разберём оба источника проблем.
Маркетинговые акции создают временные всплески спроса, после которых нередко следует провал ниже базового уровня. Если в данных не пометить даты промо, модель воспримет выброс как норму и даст искажённый базовый прогноз.
Ценовая политика влияет нелинейно: эластичность спроса (изменение объёма при изменении цены) различается по категориям. Регрессионный анализ позволяет оценить этот параметр и встроить его в модель прогнозирования.
Ассортиментные изменения — ещё один источник искажений. Если товар отсутствовал на полке, нулевые продажи в этот период не отражают реальный спрос: упущенный спрос нужно восстановить в данных. Онлайн и офлайн-каналы дают разные паттерны покупок — для каждого канала лучше строить отдельный прогноз.
Внешние факторы — сезонность, макроэкономическая ситуация, действия конкурентов, погода, социальные события — не поддаются прямому контролю, но влияют на поведение потребителей. Их учёт требует либо включения в регрессионную модель, либо отдельной поправки к базовому прогнозу.
Аномалии в данных — системная проблема. Дефицит (нулевые продажи ≠ нулевой спрос), разовые акционные всплески, ошибки учёта — всё это искажает историю. Очистка данных не опциональный шаг, а обязательное условие: без неё прогноз будет систематически неточным вне зависимости от качества выбранного метода.
Работа с историческими данными, временны́ми рядами и прогностическими моделями — прикладной навык, который можно освоить с нуля. Если хотите разобраться глубже, посмотрите программу Data-аналитик: Python и SQL в анализе данных: от 29 900 ₽ со скидкой по господдержке, онлайн, без отрыва от работы.
Методы прогнозирования спроса делятся на три класса: качественные (экспертные суждения), количественные (статистические модели) и ML-методы (машинное обучение и нейронные сети). Каждый класс подходит для разных условий: горизонта, типа спроса, объёма данных и числа SKU.
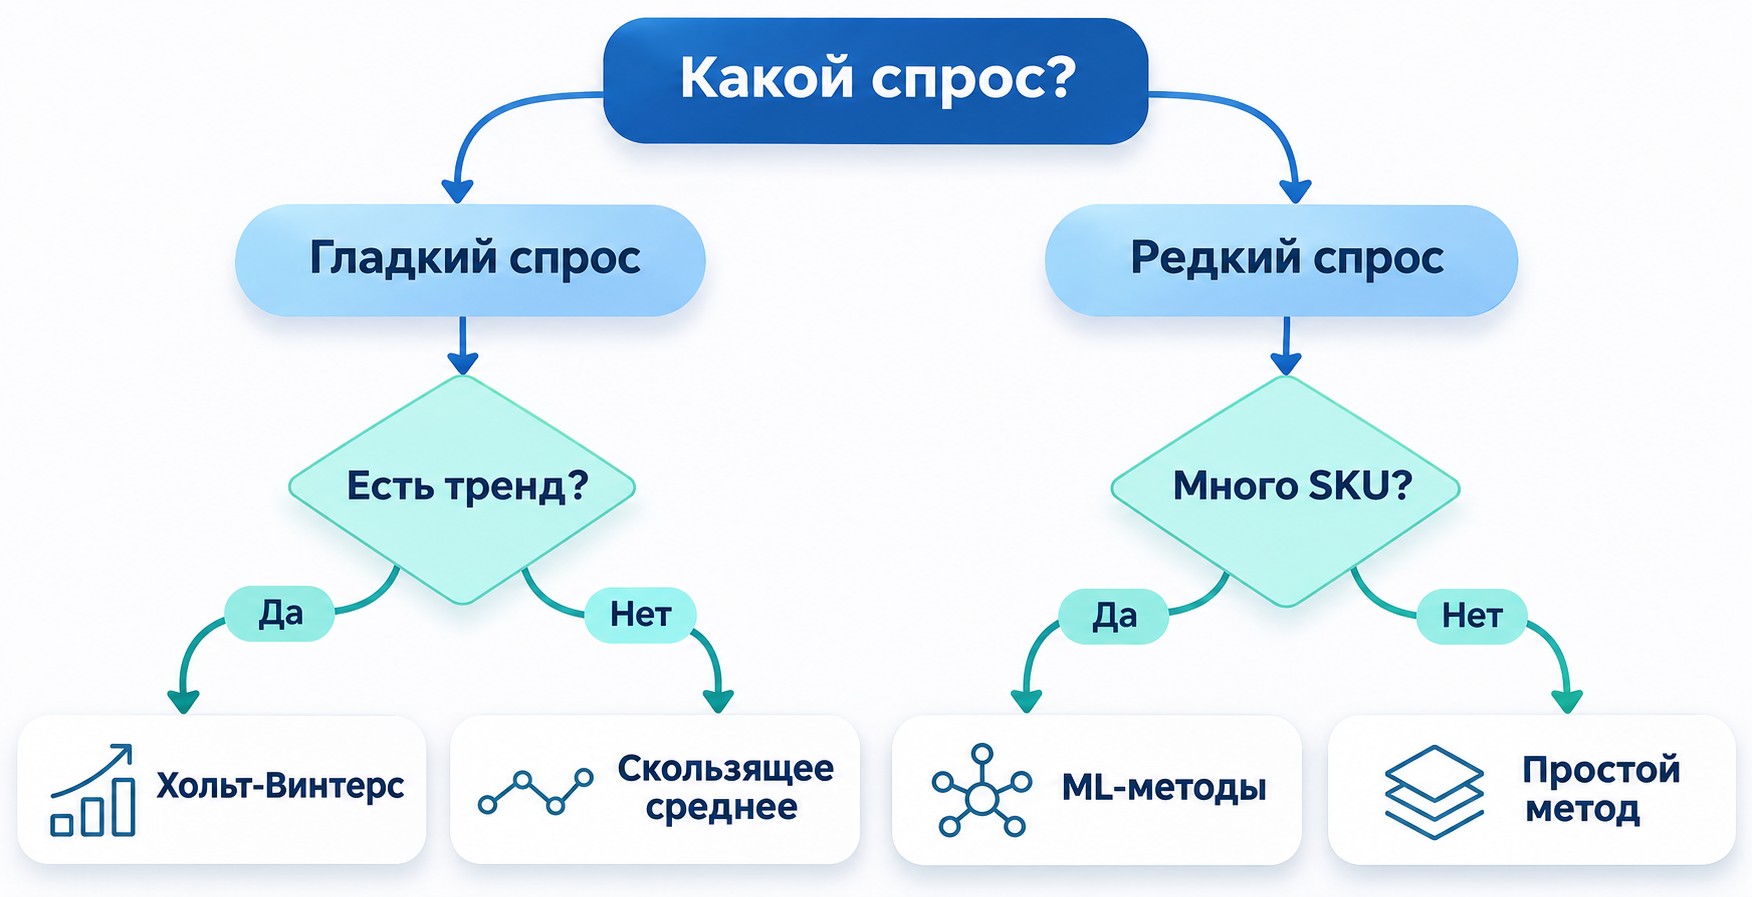
Универсального метода не существует. Оптимальный способ выбора — бэктест: проверка нескольких моделей на исторических данных и выбор той, у которой минимальный MAPE. Дерево решений помогает сузить набор кандидатов перед бэктестом: от типа спроса (гладкий или редкий) — к наличию тренда и сезонности, затем к объёму SKU и внешним факторам.
Качественные методы применяются там, где история продаж отсутствует или нерелевантна: новые продукты, выход на новые географии, нестандартные рынки.
Метод экспертных оценок опирается на суждения специалистов — коммерческих директоров, категорийных менеджеров, дистрибьюторов. Преимущество — учёт неформальных факторов (рыночные тенденции, переговоры с ключевыми клиентами). Ограничение — субъективность и возможные когнитивные искажения.
Метод Дельфи снижает субъективность через анонимный итеративный опрос группы экспертов. После каждого раунда участники видят усреднённые ответы и могут скорректировать позицию. Применяется для долгосрочного планирования спроса на горизонте 1–3 года.
Маркетинговые исследования — опросы потребителей и фокус-группы — дают прямой сигнал рынка. Метод дорогостоящий, но незаменим при выводе новинки, когда нет ни одной аналогии в исторических данных.
Когда применять: нет истории продаж, новый продукт, выход в новый регион или нестандартный рынок, где статистические модели не могут быть обучены на реальных данных.
Количественные методы используют исторические данные о продажах и временны́е ряды. Это основа прогнозирования спроса на основе статистики для большинства розничных и дистрибьюторских компаний.
Скользящее среднее (Moving Average): F(t+1) = (D(t) + D(t-1) + … + D(t-n+1)) / n
Пример с «окном» n = 3: Январь = 120, Февраль = 135, Март = 110 → прогноз на апрель = (120 + 135 + 110) / 3 = 121,7 ед. Оптимальное окно выбирается перебором: выбирают n с минимальным RMSE на исторических данных.
Экспоненциальное сглаживание: F(t+1) = α × D(t) + (1 – α) × F(t)
Параметр α (от 0 до 1) задаёт вес последних данных. Высокий α — быстрее реагирует на изменения, но чувствительнее к шуму.
Метод Хольта-Винтерса (трёхпараметрическое экспоненциальное сглаживание): учитывает уровень (α), тренд (β) и сезонность (γ). Оптимален для товаров с выраженной сезонностью и устойчивым трендом.
Авторегрессия ARIMA/SARIMA: детально анализирует лаговые зависимости во временно́м ряду. Сложная настройка, подходит для среднего и долгосрочного горизонта.
Регрессионный анализ: Y = a + bX. Позволяет встроить в модель внешние факторы — цену, промо-активность, сезонный индекс.
Пора сменить профессию? Начните с понятного плана
Подберите программу под ваш опыт, цели и желаемый формат занятости
| Метод |
Формула (упрощённо) |
Лучшее применение |
Горизонт |
Тип спроса |
|---|---|---|---|---|
| Скользящее среднее | (D1+…+Dn) / n | Гладкий без тренда | Краткосрочный | Гладкий |
| Экспоненциальное сглаживание | α×Dt + (1–α)×Ft | Быстро меняющийся | Краткосрочный | Гладкий |
| Хольт-Винтерс | 3 параметра: α, β, γ | Сезонный с трендом | Кратко–средне | Гладкий |
| ARIMA/SARIMA | Авторегрессия + MA + сезонность | Сложные ряды с циклами | Средне–долго | Гладкий |
| Регрессионный анализ | Y = a + bX | Спрос с внешними факторами | Любой | Гладкий |
Машинное обучение и нейронные сети превосходят классику на больших массивах данных: тысячи SKU, несколько лет истории, сложные нелинейные зависимости. Они выявляют скрытые паттерны, которые статистические модели не улавливают.
Нейронные сети (LSTM, Transformer-based) работают как «чёрный ящик» — интерпретируемость низкая. Требуют минимум 2–3 лет истории и значительных вычислительных ресурсов. Prophet (open-source библиотека Meta) проще в настройке: хорошо справляется с суточной и недельной сезонностью, распознаёт выходные и праздники как отдельный фактор.
Для редкого спроса оптимальны вероятностные модели (метод Кростона и его варианты): они не прогнозируют точечное число продаж, а рассчитывают распределение вероятностей — из него выводится оптимальный запас при заданном уровне сервиса.
| Параметр |
Классика (Хольт-Винтерс) |
ML (нейронная сеть) |
|---|---|---|
| Средний MAPE (FMCG) | 12–18% | 8–13% |
| Минимум истории | 1–2 года | 2–3+ года |
| Сложность внедрения | Низкая | Высокая |
| Интерпретируемость | Высокая | Низкая |
| Стоимость | Низкая | Высокая |
Классические методы против машинного обучения: сравнение по ключевым параметрам. Данные ориентировочные — реальный результат зависит от категории и качества данных.
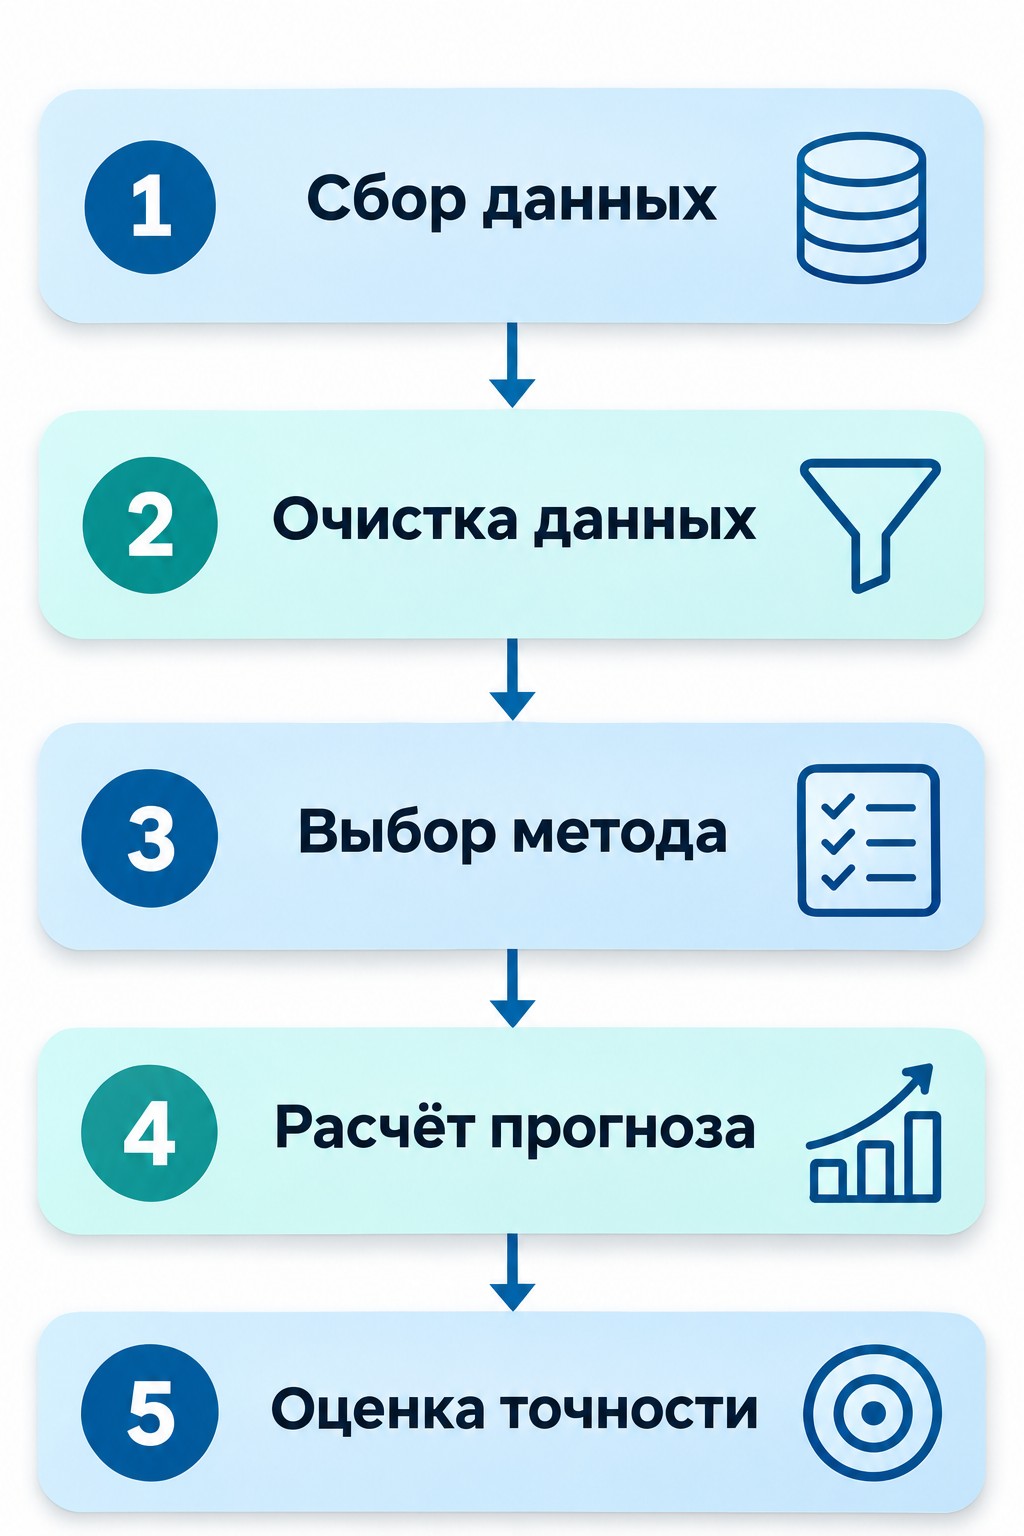
Прогнозирование — не разовое действие, а повторяющийся цикл. Алгоритм из пяти шагов применим к любому типу бизнеса: от небольшого интернет-магазина до крупного дистрибьютора.
Шаг 1 — Определить тип спроса. Рассчитайте среднее расстояние между продажами по каждому SKU. Менее 1,25 дня — гладкий спрос, более 1,25 дня — редкий. Это решение определяет весь дальнейший выбор метода.
Шаг 2 — Собрать данные. История продаж по каждой позиции, складские остатки, даты маркетинговых акций, lead time поставщиков, сезонный календарь праздников и выходных.
Шаг 3 — Очистить данные. Восстановить скрытый спрос в периоды дефицита (когда продажи = 0, но реальный спрос был). Отделить «базовый» спрос от промо-пиков. Исключить ошибки учёта.
Шаг 4 — Выбрать метод по дереву решений. Тип спроса → наличие тренда и сезонности → объём SKU → внешние факторы. Итог — набор кандидатов для бэктеста.
Шаг 5 — Рассчитать прогноз и проверить точность (бэктест). Запустите несколько моделей на исторических данных, сравните MAPE. Выберите модель с наименьшей ошибкой. Итерируйте: прогноз должен обновляться регулярно — по мере поступления новых данных о продажах.
Прогноз без измерения — гипотеза. Регулярная оценка точности — обязательная часть замкнутого цикла планирования и поставок. Пять метрик, которые используют специалисты по управлению запасами:
| Метрика |
Формула |
Пример |
Интерпретация |
Порог |
|---|---|---|---|---|
| MAPE | Σ|факт–прогноз|/факт × 100% | 12% | Ошибка в среднем 12% | <10% — отлично; 10–20% — приемлемо; >20% — смена модели |
| MAD | Σ|факт–прогноз| / n | 45 ед. | Среднее отклонение в единицах | Зависит от масштаба SKU |
| RMSE | √(Σ(факт–прогноз)²/n) | 62 ед. | Чувствителен к крупным выбросам | Используется для подбора «окна» n |
| Bias | Σ(прогноз–факт) / n | +15 | Систематическое завышение | >0 → снизить α; <0 → повысить α |
| FVA | MAPE(прогноз) – MAPE(с правкой) | –2% | Правки ухудшают прогноз | FVA<0 → отключить корректировки |
Порог MAPE в 10% — ориентир для товаров с гладким спросом. Для сезонных или нестабильных категорий приемлемый порог выше.
Forecast Value Added (FVA) — одна из редко обсуждаемых, но важных метрик. Она отвечает на вопрос: улучшают ли ручные корректировки точность прогноза? Если FVA отрицательный — аналитик в среднем ухудшает прогноз своими правками. В этом случае лучше довериться модели.
Bias сигнализирует о систематическом смещении: если прогноз регулярно выше фактических продаж (Bias > 0), стоит снизить параметр α в модели экспоненциального сглаживания. Если ниже (Bias < 0) — повысить.
Выбор инструмента зависит от масштаба бизнеса: количества SKU, бюджета, необходимых методов и интеграции с учётными системами (ERP-системами, 1С).
| Инструмент |
Тип |
SKU |
Бесплатно |
Интеграция |
|---|---|---|---|---|
| Excel | Таблица | До 500 | Да (пакет Office) | Ручной импорт |
| Python + Prophet | Open-source | Без ограничений | Да | API, CSV |
| Forecast Pro | Специализированное ПО | 500–50 000 | Нет | Excel, ERP |
| SAP IBP | Enterprise | >50 000 | Нет | SAP ERP |
| Oracle Demantra | Enterprise | >50 000 | Нет | Oracle ERP |
| 1С: ERP + DP | ERP | 1 000–30 000 | Нет | 1С, нативно |
Прежде чем выбирать инструмент, полезно провести XYZ-анализ — сегментацию SKU по стабильности спроса. Товары группы X (коэффициент вариации CV < 10%) прогнозируются хорошо любым статистическим методом. Группа Y (CV 10–25%) требует комбинированного подхода. Группа Z (CV > 25%) — нестабильный спрос, лучше прогнозировать экспертными методами или вероятностными моделями. XYZ-анализ обычно применяется в паре с ABC-анализом и становится первым шагом перед выбором модели прогнозирования.
Логика выбора инструмента простая: Excel — для старта и малого ассортимента; специализированное ПО — когда SKU перевалило за несколько сотен; Enterprise-решения — для масштаба с тысячами позиций и интеграцией в корпоративную ERP. Автоматизация закупок на основе прогноза кратно снижает влияние человеческого фактора и высвобождает время аналитика для интерпретации, а не расчётов.
MAPE ниже 10% — отличный результат для большинства категорий. Значение 10–20% считается приемлемым и встречается в FMCG и сезонных товарах. Если MAPE превышает 20%, стоит пересмотреть модель, проверить качество исторических данных или добавить учёт внешних факторов.
Прогнозирование спроса оценивает реальную потребность рынка, включая случаи, когда товара не было в наличии. Прогнозирование продаж опирается лишь на фактически совершённые сделки, занижая истинный спрос при дефиците. Разница важна: неочищенная история продаж ведёт к систематическому занижению прогноза.
Для товаров с редким спросом обычные методы не подходят — точечный прогноз будет давать большую ошибку. Вместо этого применяют вероятностные модели (метод Кростона), которые рассчитывают оптимальный запас через распределение вероятностей, а не пытаются угадать точное число продаж.
Да — Excel подходит для малого бизнеса с ассортиментом до 500–1000 SKU. Встроенные функции ТЕНДЕНЦИЯ и РОСТ реализуют трендовую экстраполяцию, надстройка «Анализ данных» позволяет строить скользящие средние. Ограничение: Excel не учитывает акции, аномалии и редкий спрос автоматически.
Нейронные сети показывают наибольшую точность при наличии большого массива данных (3+ года, тысячи SKU). Однако для компаний среднего размера метод Хольта-Винтерса или экспоненциальное сглаживание нередко сопоставимы по MAPE при значительно меньших затратах на внедрение.
Выраженная сезонность (одежда, напитки, учебные принадлежности) требует методов, явно учитывающих цикличность: Хольта-Винтерса (три параметра: уровень, тренд, сезонность) или SARIMA. Простые методы — скользящее среднее, базовое экспоненциальное сглаживание — сезонность не учитывают и дадут высокую ошибку.
XYZ-анализ классифицирует товары по стабильности спроса: X (CV < 10%) — стабильный, Y (10–25%) — умеренный, Z (> 25%) — нестабильный. Результат определяет выбор метода: для X — статистические модели, для Z — экспертная оценка. Используется в паре с ABC-анализом для полной сегментации ассортимента.
Forecast Value Added (FVA) — метрика, показывающая, улучшают ли ручные корректировки точность прогноза. Если FVA отрицательный, аналитик в среднем ухудшает прогноз своими правками — и от корректировок лучше отказаться. Это один из современных инструментов оптимизации процесса планирования.
Страховой запас — буфер против неопределённости спроса и сроков поставки. Рассчитывается как квантиль накопительного распределения спроса на период lead time при целевом уровне сервиса (например, P90 для LOS 90%). Чем точнее прогноз — тем меньший буфер требуется при том же уровне сервиса.
Частота зависит от горизонта и отрасли: для FMCG и розницы — ежедневно или еженедельно; для производства — ежемесячно. Прогнозы «стареют» — чем дольше не обновляется модель, тем выше накапливается ошибка. Современные системы пересчитывают прогноз автоматически при поступлении новых данных о продажах.
Превратите интерес к теме в новую профессию
Оставьте заявку — поможем выбрать программу и расскажем об условиях обучения
Оставить заявку


 Задать вопрос


 Задать вопрос