20 апреля 2026 года ChatGPT, Claude и Gemini упали одновременно. Тысячи команд встали на несколько часов без доступа к ИИ-инструментам, которые уже стали частью ежедневной работы. Тогда многие впервые задумались: облачный ИИ — это инфраструктура чужой компании, и в любой момент она может стать недоступной.
Локальные нейросети устроены иначе. Модель скачивается один раз и работает полностью на вашем компьютере: никакого сервера, никаких подписок, никакого риска блокировки. Данные не покидают жёсткий диск — это особенно важно при работе с конфиденциальными документами или клиентской информацией.

Сделайте следующий шаг в карьере
Подберите обучение, которое поможет освоить новые компетенции
В этом руководстве разберём, как выбрать модель под ваше железо, какую программу-оболочку использовать и как запустить нейросеть на ПК за 10 минут — даже без видеокарты.
Локальная нейросеть (или локальная LLM — языковая модель) — это модель ИИ, которая запускается и работает целиком на ресурсах вашего устройства. В отличие от облачного ИИ, здесь нет запроса на удалённый сервер: вычисления выполняет GPU (графический процессор) или CPU (центральный процессор) вашего компьютера, а данные хранятся локально.
Принцип прост: интернет нужен только один раз — чтобы скачать оболочку и файл модели. После этого нейросеть работает офлайн.
Большинство открытых моделей распространяются в формате GGUF (файлы с расширением .gguf) — это квантованные веса, загружаемые через движок llama.cpp. Квантование работает как ZIP-архив для нейросети: веса уменьшаются с 16 бит до 4–8, размер файла сокращается в 6–8 раз, а потеря качества не превышает 1–2%. Благодаря этому модель в 7 миллиардов параметров помещается на обычный жёсткий диск и запускается на потребительском железе.
Локальные нейросети делятся по задачам: текстовые языковые модели, генерация изображений, обработка аудио и мультимодальные модели. Под каждую задачу — свои требования к железу и набор инструментов. GGUF-файлы размещены на платформе Hugging Face — единственной массовой площадке для их дистрибуции. Если вас интересует именно текстовое направление, среди языковых моделей есть чёткая иерархия по качеству и ресурсоёмкости — её отражает актуальный рейтинг нейросетей для генерации текста.
Главный аргумент — конфиденциальность данных. Когда вы отправляете запрос в облачный сервис, текст уходит на серверы корпорации. Для юристов, медицинских работников и команд, связанных договорами о неразглашении, это неприемлемо. Локальный ИИ обрабатывает данные внутри устройства — утечка данных исключена по архитектуре.
Второй аргумент — независимость. Несколько крупных облачных сервисов ограничили доступ для отдельных регионов или внезапно изменили условия API. Блокировки API, санкционные решения, плановые работы — локальная модель, скачанная однажды, на всё это не реагирует.
Третий — экономия. Абонентская плата за несколько облачных подписок складывается в значительную сумму на каждого специалиста. Локальный ИИ требует только электроэнергию и амортизацию железа: по опыту пользователей, вложения в оборудование окупаются менее чем за 6 месяцев.
Наконец, нет встроенной цензуры и лимитов на запросы. Модель не обрывает разговор на 20-м сообщении и не требует ждать сброса суточного лимита.
| Характеристика |
Локальный ИИ |
Облачный ИИ |
|---|---|---|
| Конфиденциальность | Данные не покидают устройство | Данные уходят на серверы компании |
| Доступность | Работает офлайн | Требует интернет и стабильный сервис |
| Стоимость | Электроэнергия + железо | Ежемесячная абонентская плата |
| Скорость | Зависит от GPU | Стабильно, очереди при нагрузке |
| Лимиты запросов | Нет | RPM и TPM ограничения |
| Цензура и фильтры | Настраиваемые | Встроены в модель |
| Санкционный риск | Нет | Возможен |
Главное правило: VRAM (видеопамять) решает почти всё. Процессор при правильной настройке почти не участвует в генерации — его роль сводится к вспомогательным операциям. Два сценария: обычный ПК или ноутбук с дискретной видеокартой NVIDIA и Apple Silicon с объединённой памятью.
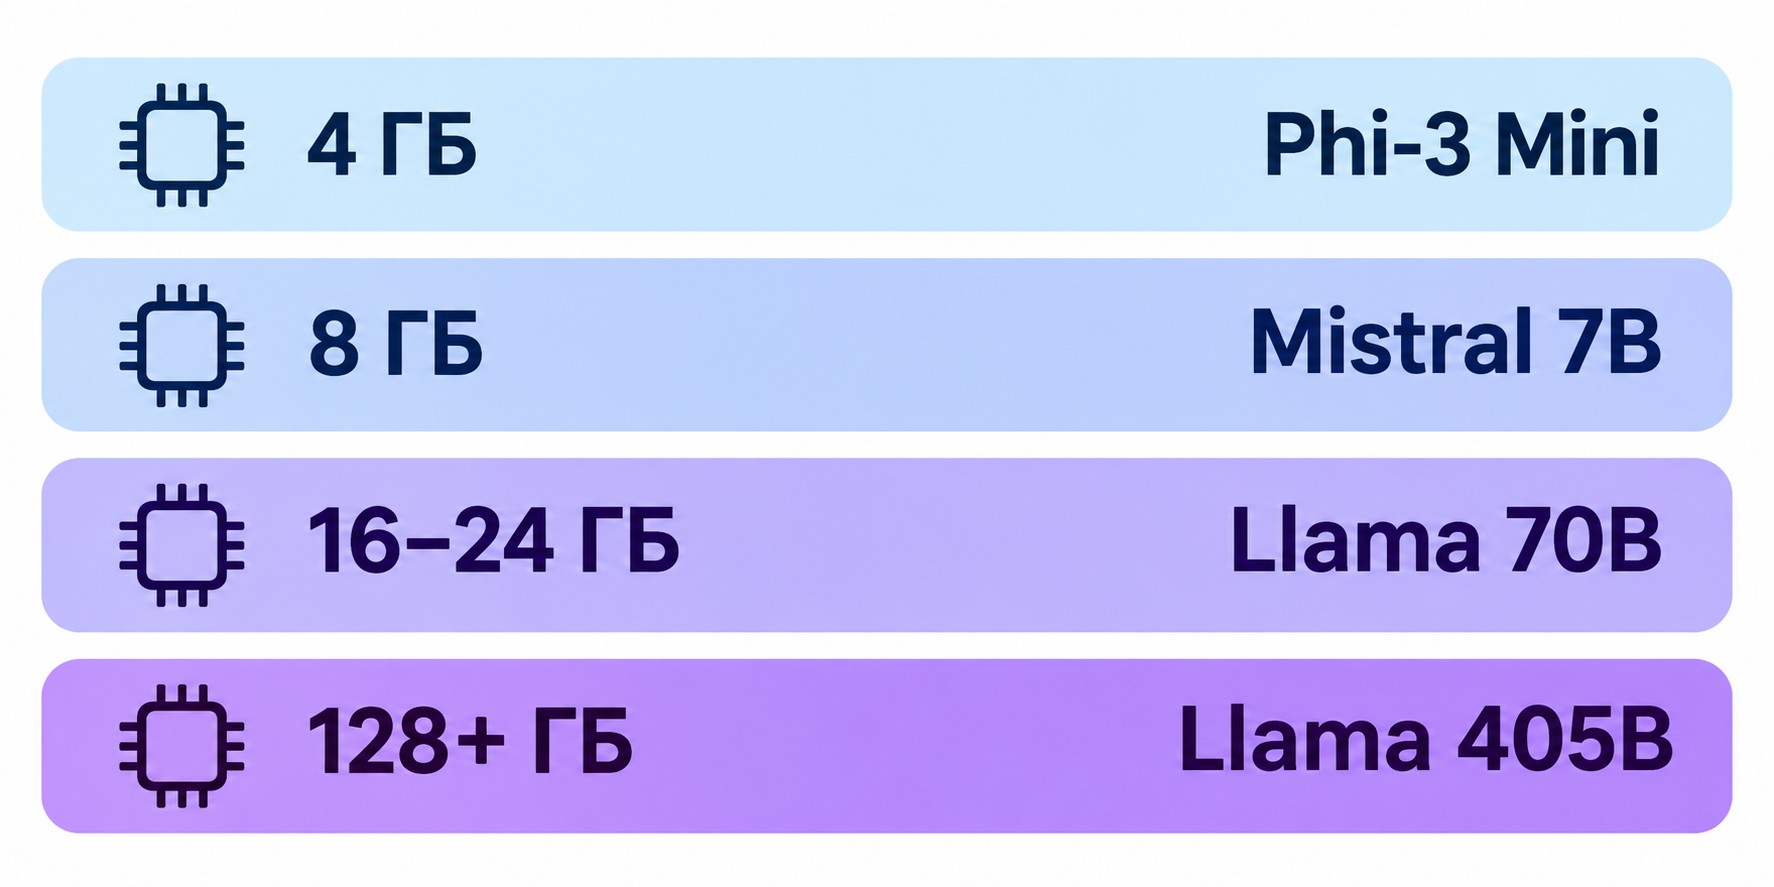
Объём видеопамяти определяет, какой размер модели вы можете запустить. Четыре ключевых уровня:
4 ГБ — компактные модели в 2–4 миллиарда параметров. Хватит для перевода, кратких резюме и простых вопросов. Типичные карты: GTX 1650, RTX 3050.
8 ГБ — золотой стандарт для входа. RTX 3060 и RTX 4060 запускают модели в 7–14B параметров с Q4-квантованием и выдают 20–40 токенов в секунду (t/s) — комфортная скорость для ежедневной работы.
16–24 ГБ — модели в 30B+ параметров, генерация изображений высокого разрешения. RTX 4090 и RTX 5090 (24 ГБ) открывают доступ к Qwen 3.6 35B и Stable Diffusion 3.5 Large.
128 ГБ — территория Apple M5 Max. Модели в 70B+ параметров, недоступные на обычном ПК без специализированного оборудования.
Самая частая проблема — ошибка out of memory: модель не помещается в видеопамять. Решение: перейти на Q4-версию вместо Q8 или FP16 — размер файла уменьшается вдвое без заметной потери качества. Второй вариант — снизить параметр GPU Offload в настройках оболочки.
У чипов Apple серии M архитектура принципиально другая: GPU и CPU используют единую высокоскоростную объединённую память — без выделенной VRAM. Apple M5 Max с 128 ГБ и пропускной способностью 614 ГБ/с работает как ПК с 128 ГБ видеопамяти. Модели в 70B+ параметров запускаются на MacBook без дискретной карты.
Нейросеть для ноутбука на Apple Silicon при работе с крупными моделями нередко обгоняет обычный ПК с RTX 4060 — ограничений по разделению памяти между системой и ИИ нет.
Если хотите научиться применять и локальные, и облачные модели ИИ в реальных рабочих задачах — посмотрите программу Нейросети для бизнеса: курс длится около 1,5 месяца, стоит 24 900 ₽ со скидкой 75% по господдержке, доступна рассрочка на 4 платежа без переплат.
Выбор модели зависит от задачи. Два ключевых параметра модели — размер (в миллиардах параметров) и контекстное окно (в токенах) — определяют возможности и требования к железу.
| Тип задачи |
Лучшие модели |
Мин. VRAM |
|---|---|---|
| Текст и диалог | Gemma 4 E4B, Qwen 3.6 35B, Llama 4 Scout | 4–32 ГБ |
| Код и логика | DeepSeek V3.2, Qwen 2.5 Coder | 8–32 ГБ |
| Русский язык | Sber GigaChat, Qwen 3.6 35B | 8–32 ГБ |
| Генерация изображений | Stable Diffusion 3.5 Large | 8+ ГБ |
| Транскрибация аудио | Whisper.cpp | 2 ГБ RAM |
| Видеогенерация | ComfyUI + видео-модели | 24+ ГБ |
Текст. Gemma 4 E4B от Google DeepMind — хороший старт: 4 миллиарда параметров, контекстное окно 128 тысяч токенов, режим thinking для задач с рассуждением, скорость до 47 t/s на хорошем GPU. Для объёмных документов — Llama 4 Scout от Meta (контекст 10 миллионов токенов). Qwen 3.6 35B от Alibaba силён и по русскому языку, и по коду, но требует 32 ГБ RAM.
Код и логика. DeepSeek V3.2 набрал 79% на тесте GPQA Diamond — один из лучших результатов среди открытых моделей по задачам на программирование и логику. Сильная альтернатива — Qwen 2.5 Coder.
Изображения. Stable Diffusion 3.5 Large запускается через Forge Neo (удобный интерфейс с поддержкой закрашивания inpaint и преобразования img2img) или ComfyUI — нодовый редактор для тонкого контроля над генерацией. Минимум: 8 ГБ VRAM.
Аудио. Whisper.cpp транскрибирует речь в текст с точностью до 20 мс, полностью офлайн.
Оболочка — это программа, которая управляет скачиванием, загрузкой и запуском модели. Это не сама нейросеть, а локальное приложение для ИИ — прослойка между вами и весовым файлом. Выбор оболочки для запуска моделей зависит от уровня подготовки и задачи.
| Оболочка |
Порог входа |
Платформы |
Ключевые особенности |
|---|---|---|---|
| LM Studio | Низкий | Win / Mac / Linux | Графический интерфейс, поиск HF, GPU Offload, Flash Attention |
| GPT4All | Минимальный | Win / Mac / Linux | CPU-режим, LocalDocs для файлов |
| Jan AI | Низкий | Win / Mac / Linux | Open-source, MCP, локальный API |
| Pinokio | Минимальный | Win / Mac | Автоустановка зависимостей |
| Ollama | Высокий | Win / Mac / Linux | CLI, бэкенд для Open WebUI, Modelfile |
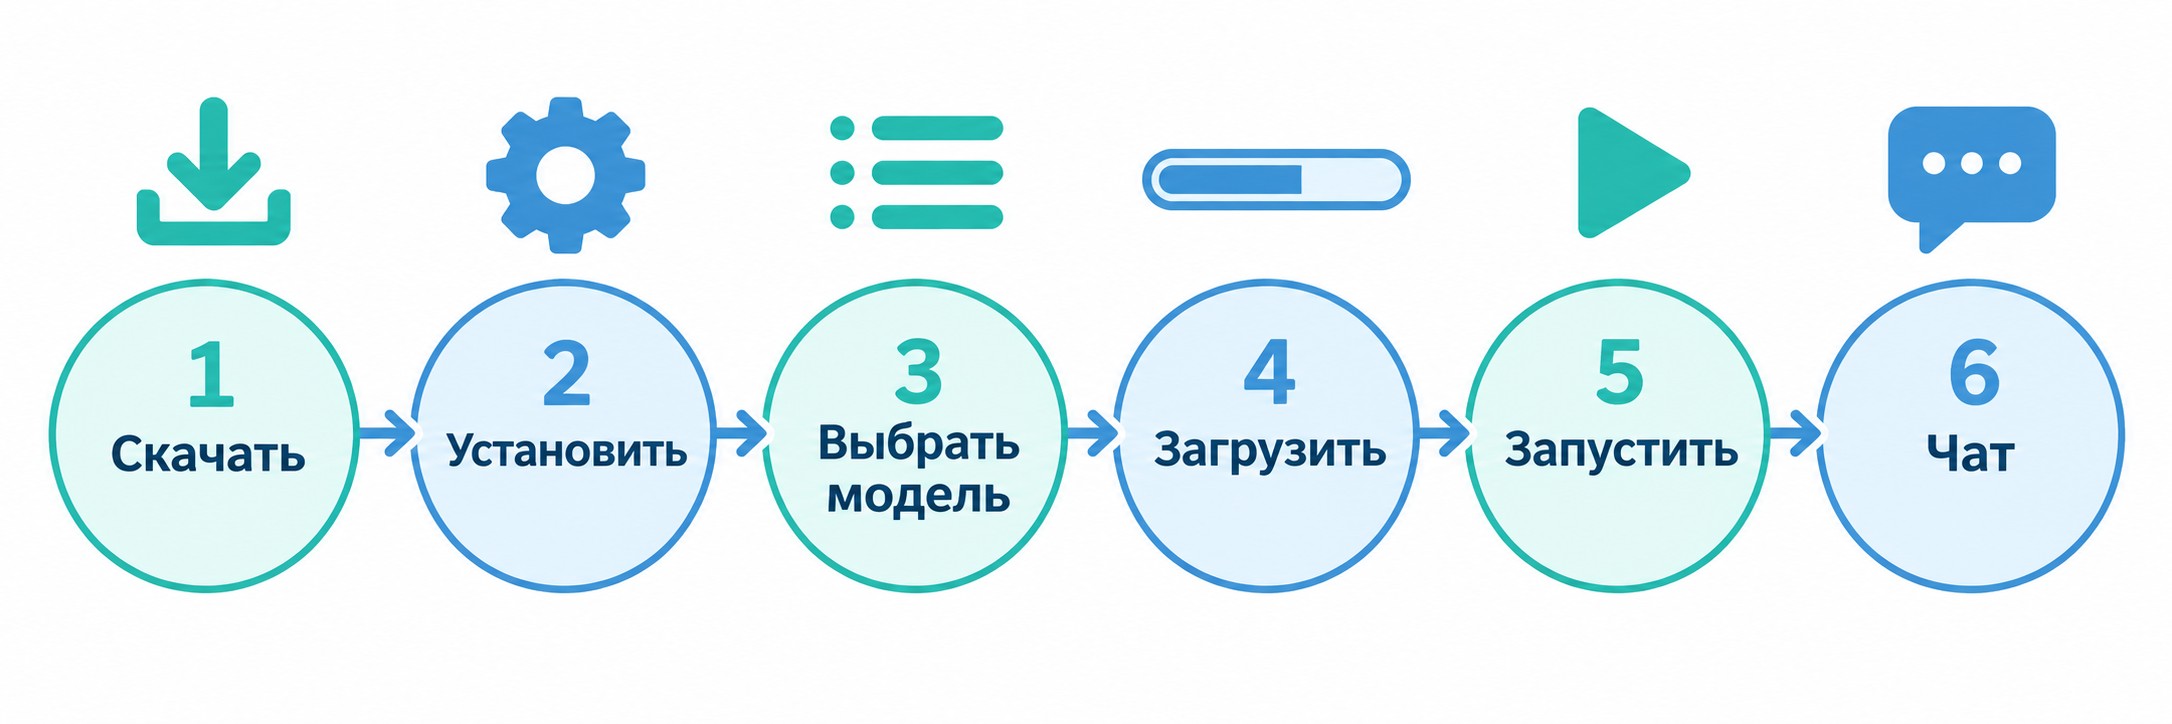
GPT4All — самый простой старт, особенно без видеокарты. Работает в CPU-режиме со скоростью около 15 токенов в секунду. Главная возможность — LocalDocs: подключаете папку с рабочими файлами, и нейросеть отвечает на вопросы по вашим документам полностью офлайн. Установка — три шага: скачать с gpt4all.io, установить (~1,5 ГБ), выбрать модель из каталога.
Jan AI — open-source альтернатива с графическим интерфейсом, похожим на LM Studio. Поддерживает MCP (протокол для подключения к внешним инструментам), CLI и локальный сервер с API. Подходит тем, кто хочет видеть исходный код того, что запускает.
Pinokio работает по принципу магазина приложений: открываешь каталог, выбираешь нужный ИИ-инструмент — и программа сама устанавливает Python, Node.js и все зависимости. Никакой ручной работы с терминалом.
Пора сменить профессию? Начните с понятного плана
Подберите программу под ваш опыт, цели и желаемый формат занятости

Ollama — CLI-первичная оболочка. Основные команды: ollama run [модель] — запустить, ollama pull [модель] — скачать, ollama ps — проверить статус. Последняя особенно полезна при настройке: если в колонке PROCESSOR написано GPU — видеокарта задействована корректно; CPU — значит, проблема с драйверами или GPU Offload. Поддерживает Modelfile для кастомизации поведения модели и является стандартным бэкендом для Open WebUI. Также поддерживает MCP.
Open WebUI — веб-интерфейс поверх Ollama. Поддерживает RAG (поиск по базе знаний через векторные представления текста), создание кастомных чат-ботов, управление несколькими моделями одновременно. Разворачивается через Docker (система контейнеризации) за несколько минут — удобный вариант для развёртывания локального ИИ-агента на ПК в рамках команды или проекта.
Два пути для старта: LM Studio — если есть дискретная видеокарта NVIDIA или AMD и нужен графический интерфейс со встроенным поиском по Hugging Face. GPT4All — если видеокарты нет или хочется протестировать без дополнительных вложений в железо. Время с установки нейросети на ПК до первого ответа — около 10 минут.
LM Studio скачивается с сайта lmstudio.ai (~400 МБ) и устанавливается как обычное приложение на Windows, Mac или Linux.
Ожидаемый результат: 47 токенов в секунду на хорошей видеокарте. Комфортный минимум — 15 t/s.
⚠️ GPU Offload — обязательный шаг. Без него модель переключается в режим CPU: скорость падает до 1–2 t/s, а процессор начинает троттлить (снижать частоты из-за перегрева).
Скорость CPU-режима — около 15 токенов в секунду. Этого достаточно для перевода текстов, резюмирования документов и Q&A по файлам. Данные не выходят за пределы вашего компьютера.
Ответ генерируется 2–3 минуты. Модель работает на CPU вместо GPU. Решение: в LM Studio поднять ползунок GPU Offload до максимума и перезагрузить модель.
Ошибка out of memory. Модель не помещается в видеопамять. Решение: переключиться на Q4-версию вместо Q8 или FP16 — размер файла сокращается вдвое. Второй вариант: немного снизить GPU Offload, чтобы часть слоёв обрабатывалась CPU.
Русский текст обрывается на полуслове. Слишком маленькое контекстное окно — модель «забыла» начало разговора. Решение: в Ollama добавить в Modelfile параметр num_ctx 4096 или выше; в LM Studio — поднять Context Length в настройках модели.
Ollama не использует видеокарту. Запустите ollama ps: если в колонке PROCESSOR стоит CPU — CUDA-драйверы устарели или не установлены. Решение: обновить драйверы NVIDIA через официальный сайт и перезапустить службу Ollama.
Forge Neo падает при генерации изображений. Видеопамять переполнена. Решение: снизить разрешение с 1024×1024 до 512×768; отключить ControlNet (модуль контроля генерации) и LoRA (дообученные адаптеры модели); закрыть другие приложения, использующие VRAM — браузер с аппаратным ускорением, игры.
Большинство популярных открытых моделей — Llama, Gemma, Qwen, DeepSeek — выходят под открытой лицензией Apache 2.0. Она разрешает публиковать и продавать контент и код, созданный нейросетью, а также использовать модели в коммерческих продуктах без дополнительных отчислений разработчику. Среди перечисленных моделей особого внимания заслуживает DeepSeek: работа с DeepSeek показала, что открытые модели способны конкурировать с проприетарными решениями в реальных коммерческих задачах.
Для корпоративных задач с официальным статусом: Sber GigaChat доступен для бизнес-применения на территории России, хорошо понимает разговорный русский и требует 8 ГБ VRAM.
⚠️ Лицензии отдельных версий моделей могут отличаться от общего правила. Перед коммерческим применением всегда проверяйте страницу конкретной модели на Hugging Face — вкладка «License».
После однократного скачивания оболочки и файла модели в формате GGUF интернет больше не нужен. Вся генерация происходит на вашем железе: данные не покидают жёсткий диск. Отключите сеть — нейросеть продолжит работать. Именно это делает локальный ИИ надёжным инструментом для работы с конфиденциальными данными.
Да. GPT4All и CPU-режим LM Studio работают без дискретной видеокарты. Скорость составит около 15 токенов в секунду — достаточно для перевода, резюме документов и ответов на вопросы по файлам. Для генерации изображений и видео видеокарта с VRAM обязательна.
Файлы размещены на платформе Hugging Face. В LM Studio встроен прямой поиск по репозиторию: введите название модели, выберите сборку с пометкой GGUF и нажмите Download. Можно и вручную: зайдите на huggingface.co, найдите нужную модель и скачайте файл.
Два лидера: Sber GigaChat (понимает разговорный сленг, официально разрешён для бизнеса, 8 ГБ VRAM) и Qwen 3.6 35B от Alibaba (силён и по русскому языку, и по коду, требует 32 ГБ RAM). Для ограниченного железа — Qwen 2.5 в версии 7B.
Квантование — математическое сжатие весов нейросети с 16 бит до 4 или 8. Модель становится в 6–8 раз меньше при потере качества около 1–2% — на практике это незаметно. GGUF — стандартный формат квантованных моделей, который поддерживают LM Studio, Ollama, GPT4All и Jan AI.
Большинство открытых моделей выходят под лицензией Apache 2.0, которая разрешает публикацию контента и продажу кода, созданного нейросетью. Sber GigaChat официально одобрен для корпоративных задач. Всегда проверяйте лицензию конкретной версии модели на странице Hugging Face перед коммерческим применением.
DeepSeek V3.2 набрал 79% на бенчмарке GPQA Diamond — тест на логику и научные задачи, — опередив многие облачные сервисы. Постоянный конкурент — Qwen 2.5 Coder, лидер опенсорс-рейтингов по качеству написания кода. Для математических задач и технической документации подойдёт Mathstral.
Да. На Android доступны PocketPal и MNN от Alibaba — мобильные обёртки над движком llama.cpp. Поддерживают компактные модели: Gemma 4 E4B, Llama 3.2 3B, Qwen 2.5 7B. Скорость ниже, чем на ПК, но достаточна для текстовых задач. На iPhone ситуация сложнее: iOS ограничивает доступ к аппаратному ускорению.
Превратите интерес к теме в новую профессию
Оставьте заявку — поможем выбрать программу и расскажем об условиях обучения
Оставить заявку


 Задать вопрос


 Задать вопрос