Обучение нейросети — это итеративная корректировка внутренних параметров (весов) модели на размеченных данных. Нейросеть делает предсказание, сравнивает его с правильным ответом, получает «штраф» через функцию потерь и немного корректирует веса. Так проходят тысячи итераций — модель становится точнее с каждым проходом по датасету.
Для старта достаточно трёх вещей: Python с библиотеками TensorFlow/Keras, размеченный датасет и GPU (Google Colab даёт карту T4 бесплатно). Полный цикл «данные → архитектура → компиляция → обучение → деплой» занимает от нескольких часов.

Сделайте следующий шаг в карьере
Подберите обучение, которое поможет освоить новые компетенции
В этой статье — семь последовательных шагов и три практических сценария. Вы разберётесь, как научить нейросеть классифицировать тексты, играть в игры через Reinforcement Learning (обучение с подкреплением) и говорить вашим голосом через дообучение готовой модели.
Если вы раньше не работали с машинным обучением — начните с раздела «Пошаговое обучение». Первый рабочий классификатор запускается в Google Colab за 1-2 дня без установки чего-либо на компьютер.
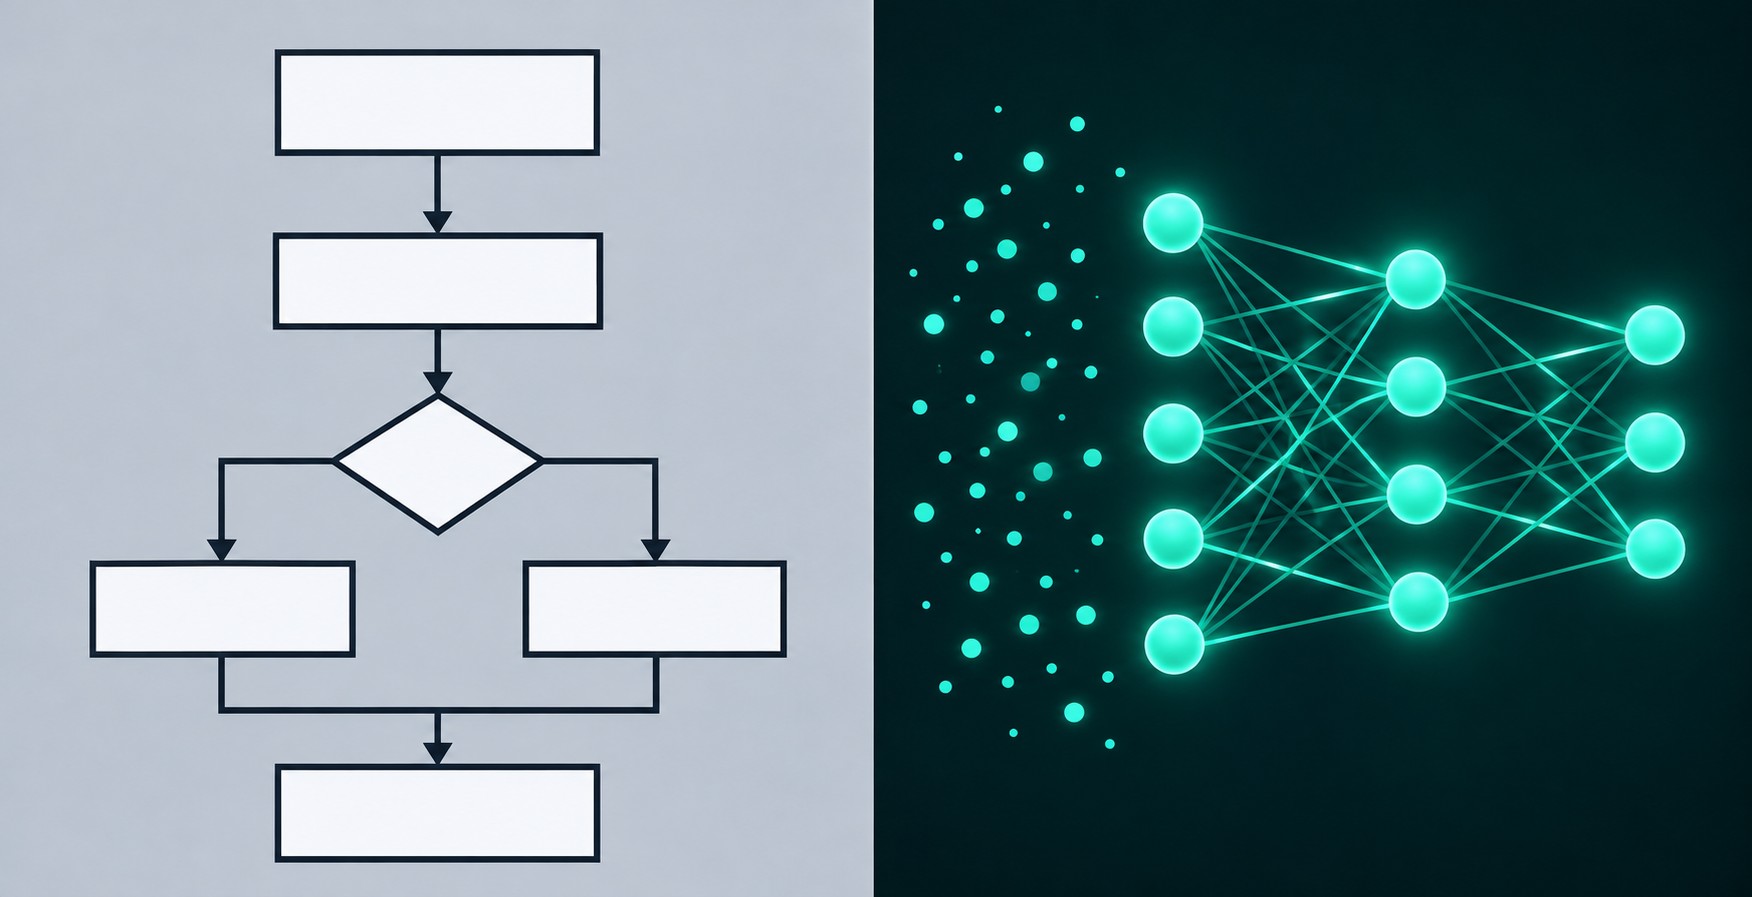
В традиционном программировании разработчик явно прописывает правила: «если текст содержит слово X — пометить как спам». Нейросеть работает иначе: она сама выводит правила из примеров. Никаких if/else — только математика и данные. Именно этот принцип лежит в основе современных нейросетей для озвучки текста — они обучались на голосовых записях и научились имитировать человеческую речь без единого жёсткого правила.
Принцип: вы показываете модели тысячи пар «вход → правильный ответ», и нейросеть ищет скрытые закономерности. Числа на входе проходят через несколько слоёв — входной, скрытые, выходной — и преобразуются в предсказание. Если предсказание неверно, оптимизатор чуть корректирует все веса. И снова. И снова.
Три основные парадигмы обучения нейросетей:
Масштаб может быть разным: учебная нейросеть с 16 000 параметров обучается за секунды, GPT-4 с около триллиона параметров — месяцами на тысячах GPU. Суть процесса одна.
Знать парадигмы нужно: от них зависит выбор инструментов. Классификатор текста — supervised learning. Игровой агент — reinforcement learning. Клонирование голоса — дообучение готовой supervised-модели на малом датасете.
Три компонента, без которых обучение нейросети с нуля не начать:
Разберём каждый из них.
Python — стандарт машинного обучения. Простой синтаксис, богатая экосистема библиотек и огромное сообщество делают его очевидным выбором для старта.
Основной стек:
Для первых проектов выбирайте TensorFlow/Keras: пять строк кода — и базовая нейросеть готова к запуску. PyTorch имеет смысл, когда нужна нестандартная архитектура или исследовательский эксперимент. Оба фреймворка поддерживает библиотека Hugging Face Transformers — она даёт доступ к тысячам предобученных моделей одной строкой кода.
Распространённый миф: для обучения нейросети нужен мощный ноутбук или компьютер. На практике все вычисления происходят в облаке — на локальном устройстве запускается только браузер.
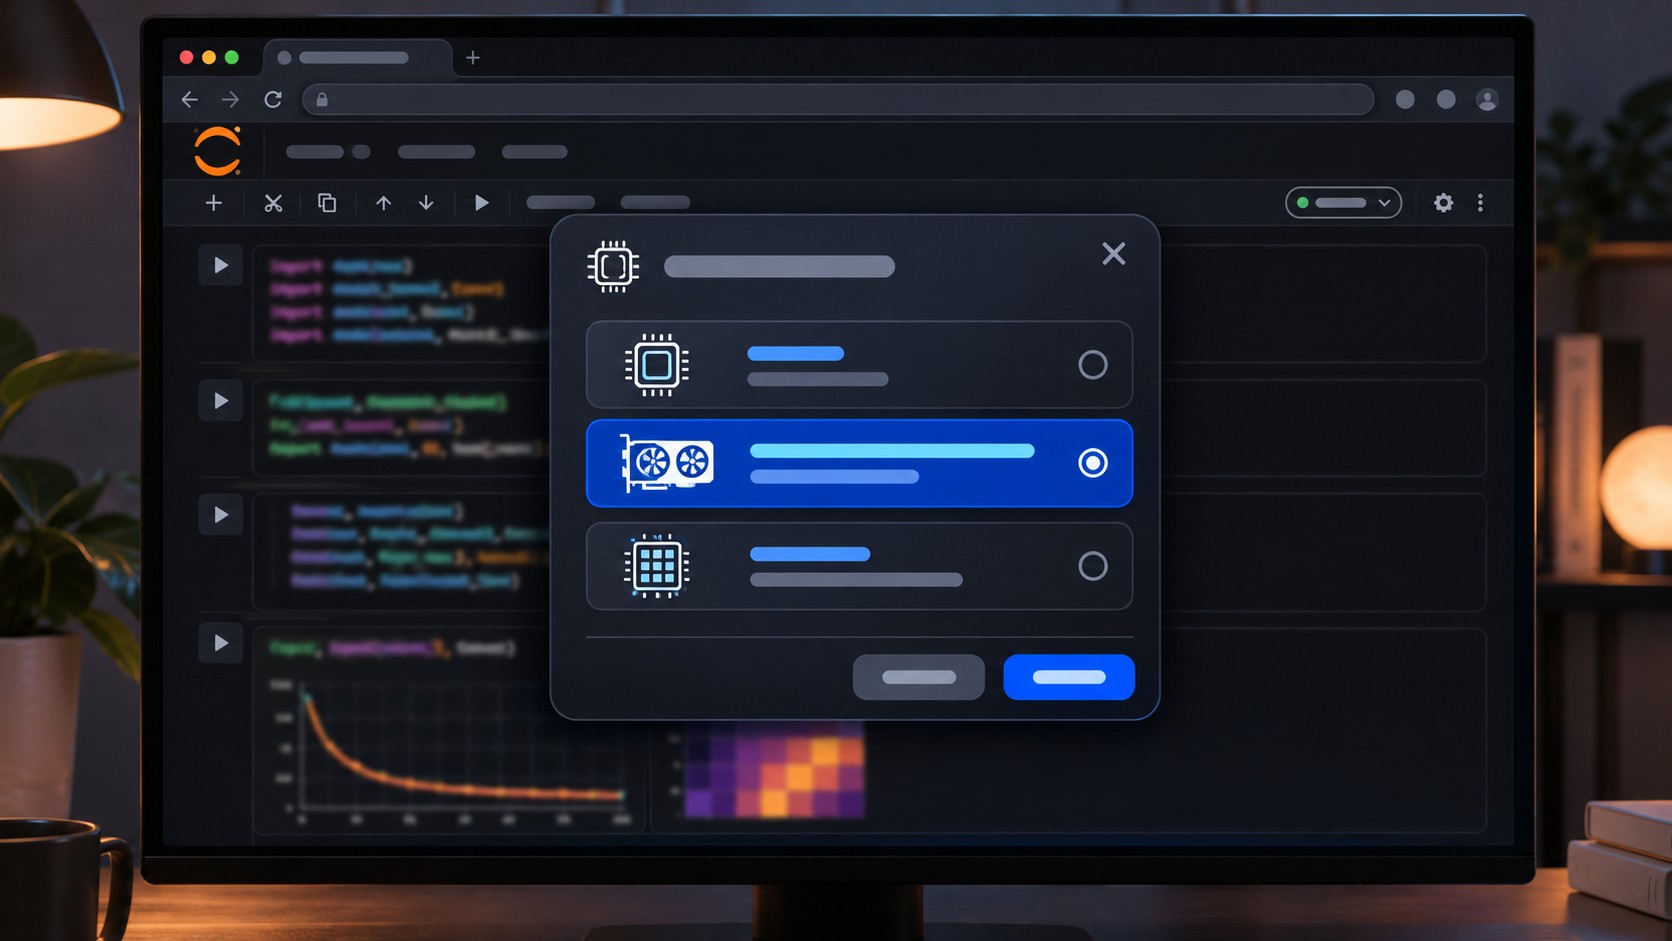
GPU (графический ускоритель) ускоряет матричные вычисления в 10-100 раз по сравнению с обычным процессором. Google Colab предоставляет карту T4 GPU бесплатно: откройте ноутбук в браузере и активируйте GPU за два клика в меню «Среда выполнения» → «Изменить тип среды выполнения».
GPU нужен, если:
Для учебных задач Google Colab с бесплатным GPU достаточно. Для долгого обучения и продакшна — платные облачные серверы.
Датасет — набор пар «X (вход) + Y (правильный ответ)». Для классификатора тональности: X — строка с отзывом, Y — 0 (негативный) или 1 (позитивный).
Форматы: CSV, JSON, SQL. Загрузка в Python: pandas.read_csv(‘data.csv’).
Где искать данные:
Критичное правило: баланс классов. Датасет 90/10 (90% одного класса) обучает нейросеть-параноика: она предсказывает большинство всегда, получает 90% accuracy и ничему не учится. Выровняйте выборку перед стартом.
Минимальный объём: 100-500 примеров для учебного проекта, 10 000+ для рабочего классификатора.
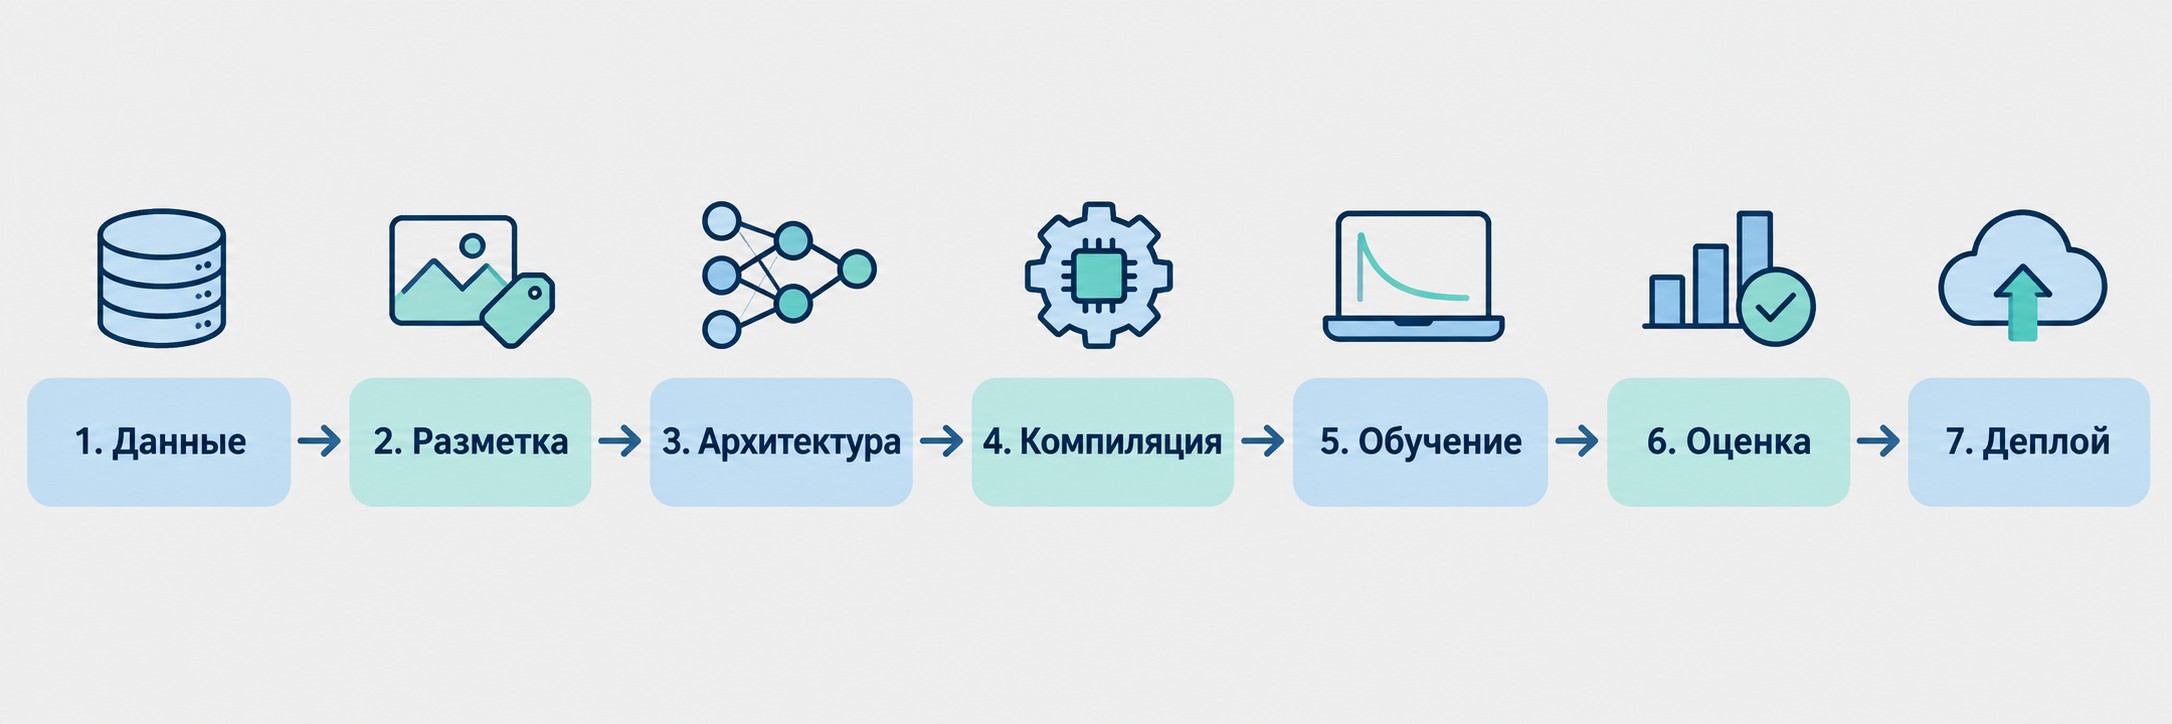
Весь процесс укладывается в семь шагов: от сырых данных до работающего сервиса. Шаги идут последовательно, возврат к предыдущим — норма: данные чистят несколько раз, архитектуру меняют по результатам обучения.
Загрузите данные и приведите к единому виду. Для текста — нижний регистр, удаление лишних пробелов и спецсимволов.
Следующий этап — токенизация: преобразование текста в числовые последовательности. Tokenizer из Keras строит словарь (каждому слову — уникальный номер) и конвертирует тексты в числовые списки. Добавьте OOV-токен (oov_token='<OOV>’) — он заменит незнакомые слова при работе с новыми текстами.
После токенизации — паддинг (padding — выравнивание): pad_sequences() делает все последовательности одинаковой длины. Нейросеть требует фиксированной размерности входных данных. Работа с размерностью и форматом входных данных — одна из ключевых задач специалиста по нейросетям на этапе проектирования пайплайна.
Финальный шаг подготовки — разбивка на обучающую и тестовую выборки в пропорции 80/20. Тестовая выборка нужна для честной оценки: модель её не видела при обучении.
Запомните: токенизатор, обученный на тренировочных данных, должен использоваться и при инференсе (inference — вывод результата). Новый токенизатор изменит индексы слов — предсказания окажутся бессмысленными.
Эмбеддинг (embedding — векторное представление) переводит токен в многомерный числовой вектор. Простая аналогия: GPS-координаты в пространстве смыслов. Слова с похожим значением оказываются рядом; «кошка» и «собака» — близко, «кошка» и «ипотека» — далеко.
Классический пример арифметики в пространстве эмбеддингов: «Король» − «Мужчина» + «Женщина» ≈ «Королева». Это работает прямо в числовом пространстве.
Keras реализует эмбеддинги через слой Embedding(vocab_size, embedding_dim). Параметр embedding_dim задаёт размерность: 16 измерений достаточно для учёбы, 64-768 — для серьёзных задач. Веса слоя обучаются автоматически вместе с остальной сетью.
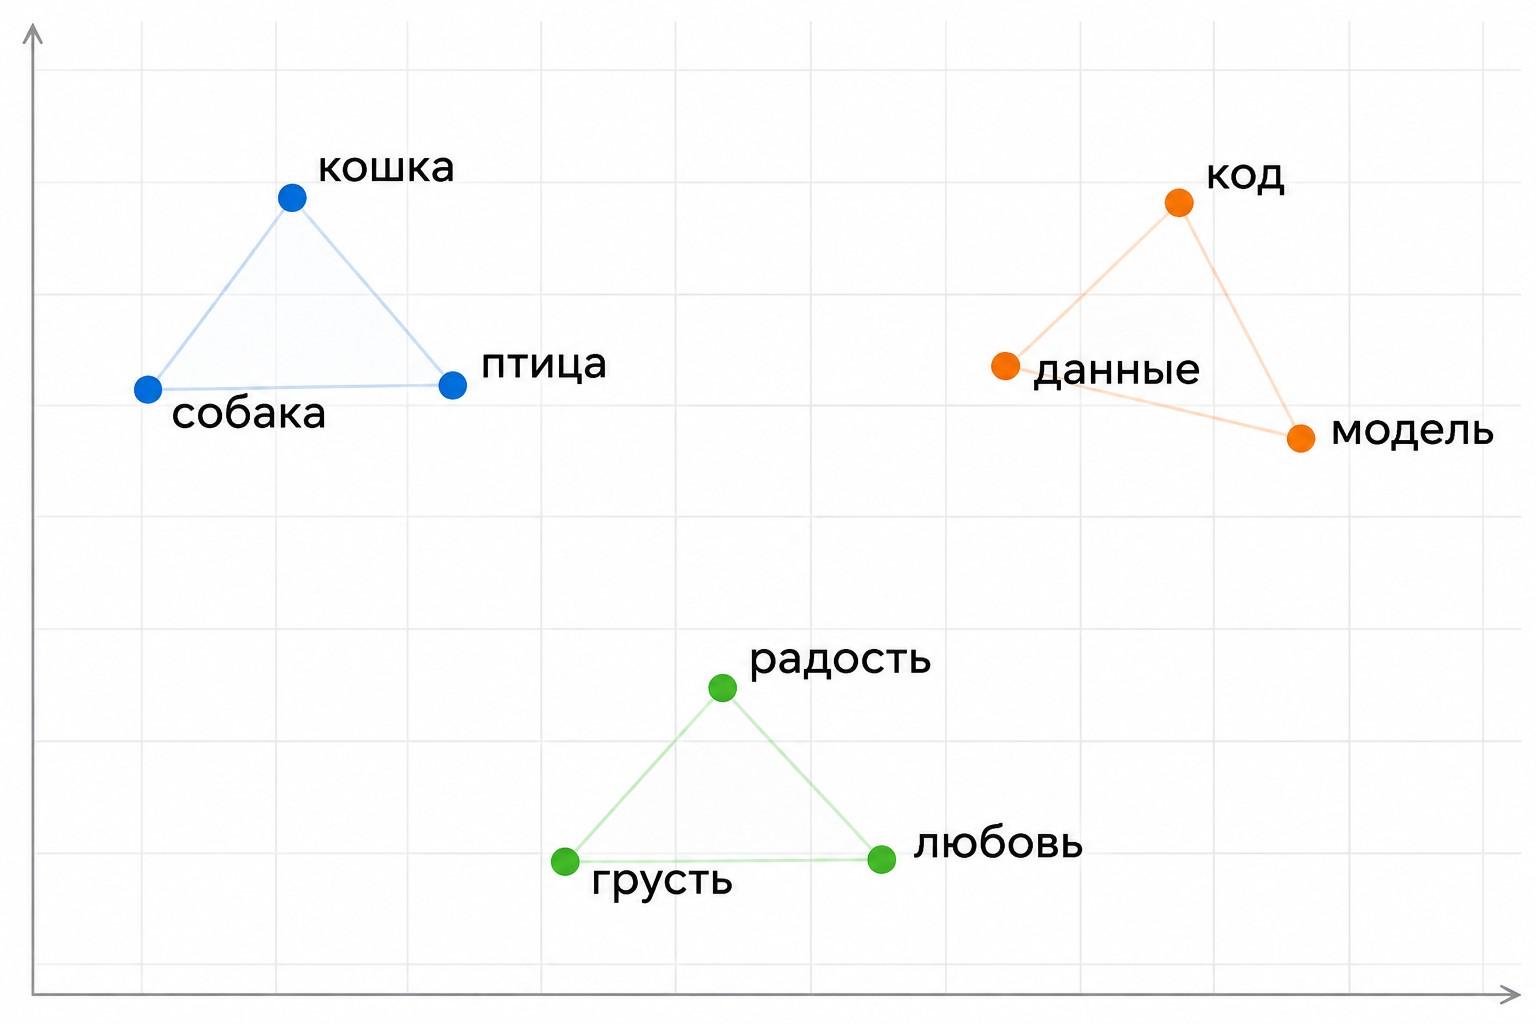
В предобученных моделях — BERT, word2vec — эмбеддинги уже настроены на огромных корпусах текста. Их можно использовать напрямую, без обучения с нуля.
В Keras архитектура строится как конструктор: Sequential() и слои один за другим.
Два популярных варианта для текстовой классификации:
Почему веса при старте случайные, а не нули? Нули дают симметричный градиент — все нейроны обновляются одинаково, и сеть не обучается. Случайная инициализация ломает эту симметрию.
Вызовите model.summary() после сборки — он покажет количество обучаемых параметров. Эти параметры и есть веса, которые будут корректироваться в процессе обучения нейросети.
Перед обучением модель компилируют: задают три параметра в model.compile().
Функция потерь (loss function) измеряет, насколько предсказание отличается от правильного ответа. Чем больше ошибка — тем больше штраф:
Оптимизатор Adam (Adaptive Moment Estimation — адаптивная оценка моментов) — золотой стандарт. Делает большие шаги в начале обучения и автоматически уменьшает их по мере приближения к минимуму функции потерь.
Метрика accuracy — доля правильных предсказаний. Accuracy 0,95 означает: 95% примеров классифицированы верно.
Запуск: model.fit(X_train, y_train, epochs=20, validation_data=(X_test, y_test)).
Одна эпоха — один полный проход по обучающему датасету. Количество эпох: 10-100 для малых датасетов, 1-5 для больших.
Что мониторить в процессе:
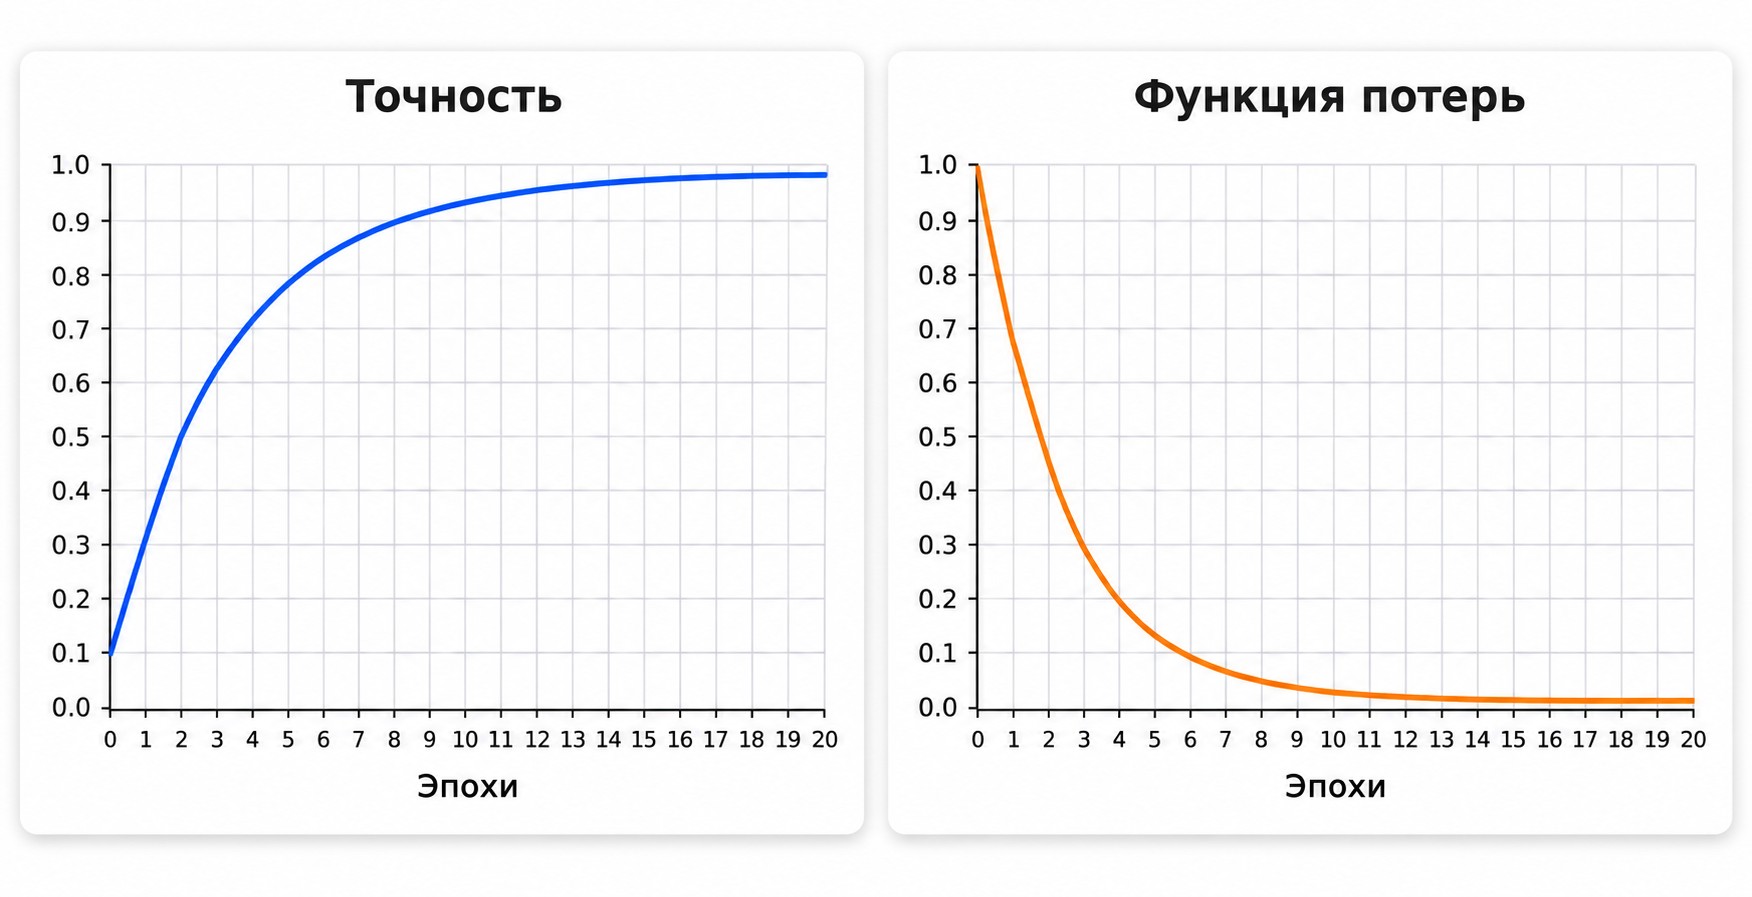
Признак тревоги: accuracy на обучающей выборке достигла 1.0 за первые 5-10 эпох, а тестовая остаётся низкой. Это переобучение — подробнее в следующем разделе.
После обучения — тест на данных, которых модель не видела. model.evaluate(X_test, y_test) вернёт финальные loss и accuracy.
Для детального анализа — model.predict(X_test): модель вернёт вероятности классов для каждого примера. Вероятность 0,87 для класса «спам» означает: модель на 87% уверена в предсказании.
Признаки хорошей модели: стабильная accuracy на разнородных примерах, похожие метрики на обучающей и тестовой выборках. Разрыв между train accuracy и test accuracy больше 15% — сигнал переобучения.
Используйте тот же токенизатор, что и при обучении: новый изменит индексы слов, и предсказания окажутся бессмысленными.
Сохранение: model.save(‘model.keras’). Дополнительно сохраните токенизатор через pickle.dump(). Оба файла обязательны — без токенизатора модель не обработает входной текст.
Четыре пути деплоя (deployment — развёртывание) модели:
Пора сменить профессию? Начните с понятного плана
Подберите программу под ваш опыт, цели и желаемый формат занятости

Загрузка: tf.keras.models.load_model(‘model.keras’) + pickle.load() для токенизатора.
Архитектура — ключевое решение при обучении нейросети. Одна задача, решённая разными архитектурами, даёт очень разный результат. Выбор зависит от природы данных и требований к точности.
| Задача |
Архитектура |
Почему |
|---|---|---|
| Классификация текста с чётким сигналом | Dense (полносвязная) | Просто, быстро, не требует GPU |
| Текст с контекстом, временные ряды | LSTM | Запоминает порядок слов, учитывает контекст |
| Изображения, видео | CNN (свёрточная нейросеть) | Находит локальные признаки независимо от положения |
| NLP с высокой точностью | Transformer (BERT, GPT) | Параллельная обработка всей последовательности |
| Игровой агент | DQN, PPO | Нет датасета — агент учится через взаимодействие со средой |
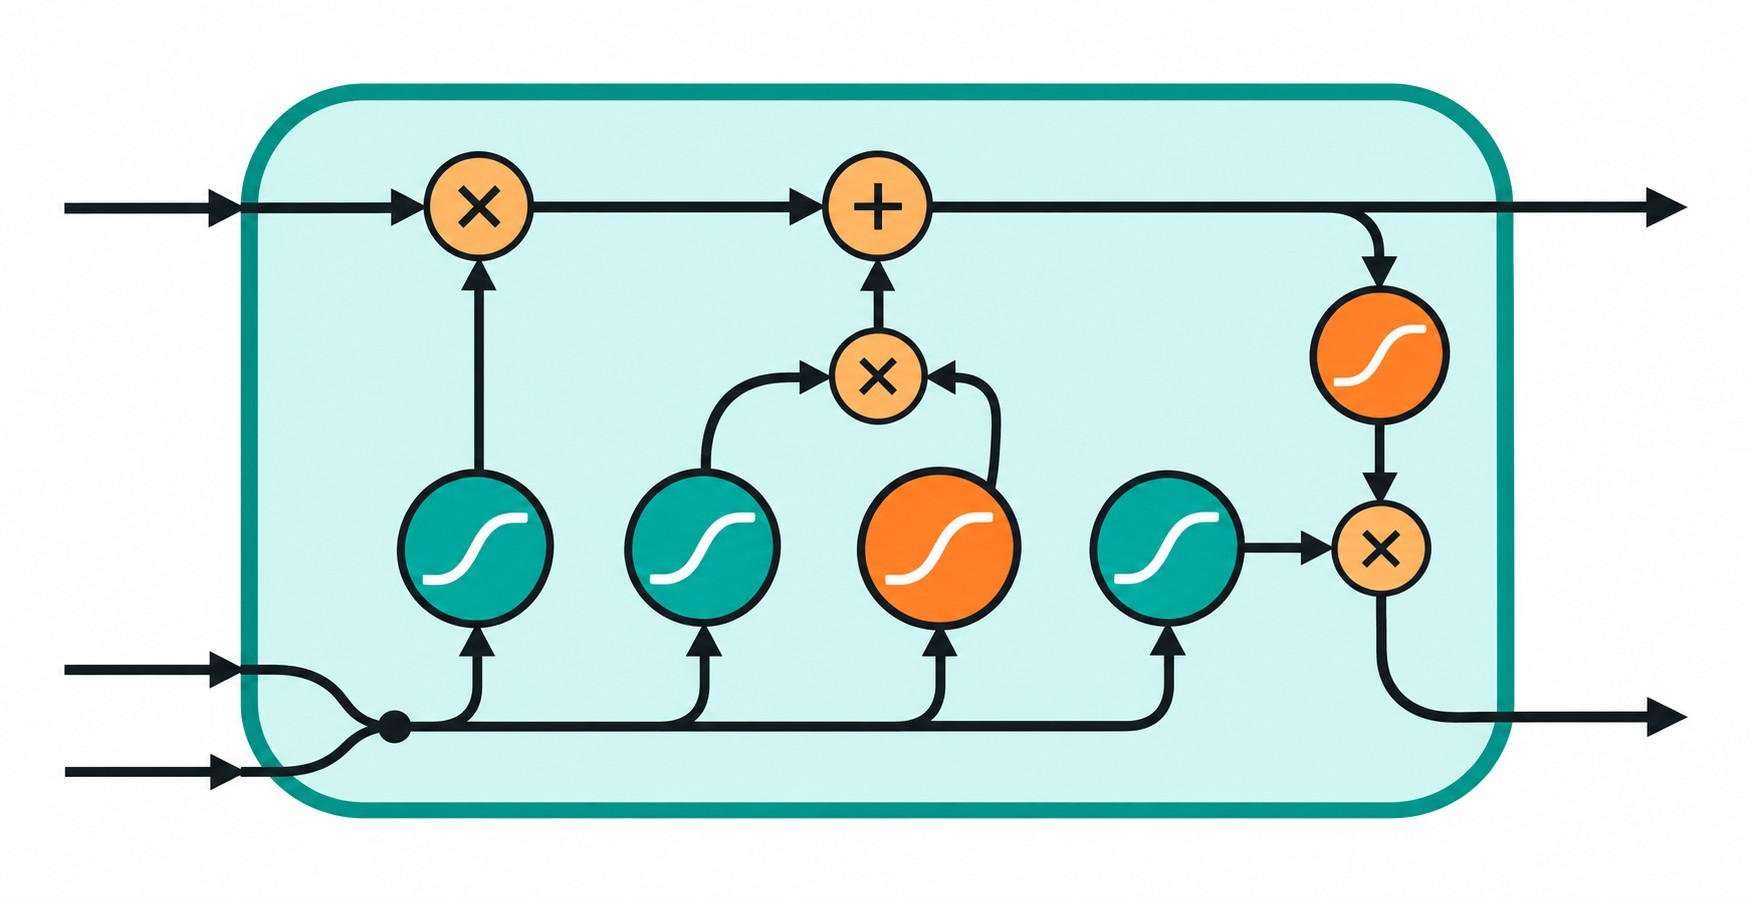
LSTM (Long Short-Term Memory — долгая краткосрочная память) — рекуррентная нейросеть с памятью. Читает текст последовательно и сохраняет контекст через четыре специальных вентиля (gate). В Keras: LSTM(128). Нужна мощнее — BiLSTM читает текст в обоих направлениях сразу.
CNN (свёрточная нейросеть) выделяет локальные признаки независимо от положения в пространстве. Распознаёт ухо кошки в правом углу и в левом одинаково хорошо. Стандарт для изображений и видео.
Transformer — современный стандарт NLP. Модели BERT и RoBERTa обрабатывают всю последовательность параллельно через механизм внимания (attention), что даёт высокую точность на GPU.
Если хотите разобраться с архитектурами нейросетей на практике — программа Нейросети для бизнеса ProfiFuture охватывает применение разных типов моделей в реальных задачах. Курс длится 1,5 месяца, доступен с господдержкой — 75% стоимости покрывает образовательная квота. В каталоге также есть программа «Data-аналитик: Python и SQL в анализе данных» для тех, кто хочет освоить Python и работу с данными системно.
Переобучение (overfitting) — ситуация, когда нейросеть идеально запомнила обучающие данные, но не умеет обобщать на новые. На тренировочной выборке accuracy = 1.0, на тестовой — 0.6. Модель зазубрила, а не поняла.
Признаки переобучения:
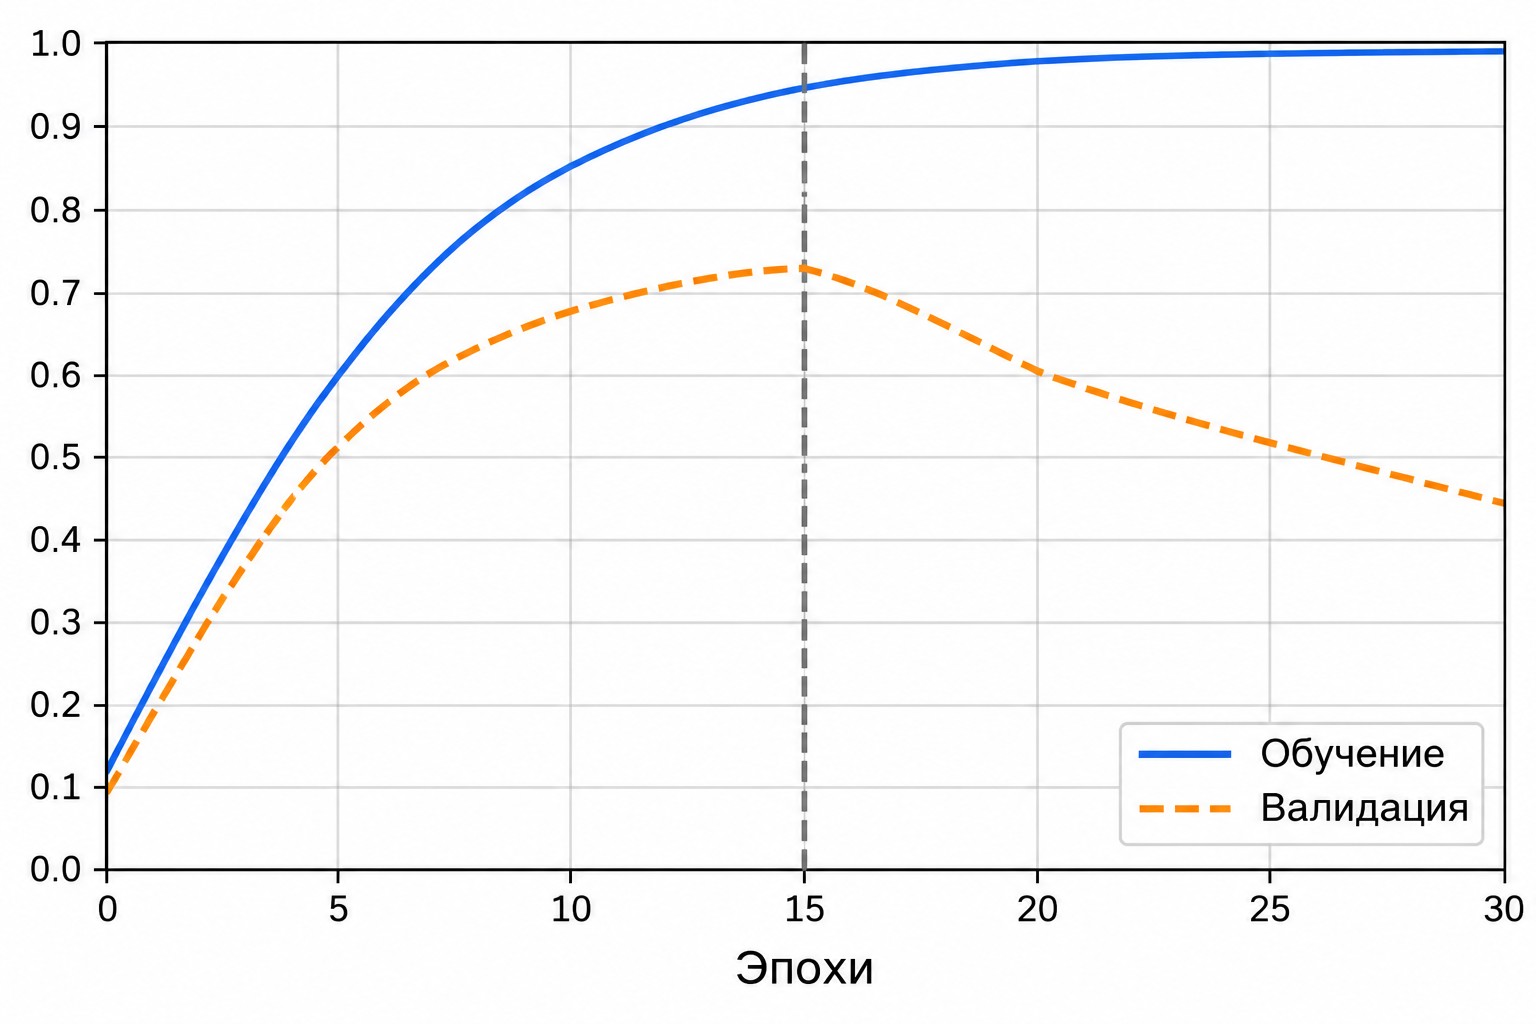
Две главные причины: малый датасет и слишком большое количество эпох.
Dropout — самый популярный метод защиты. При каждом шаге обучения случайно «отключает» часть нейронов (коэффициент 0.2-0.5). Сеть вынуждена распределять знание по нескольким путям и не может тупо запомнить конкретные примеры.
Early Stopping (ранняя остановка) — Callback, который следит за val_loss. Если метрика не улучшается N эпох подряд — останавливает обучение. Параметр patience=5 означает: терпеть пять эпох без улучшения, потом стоп.
Дисбаланс классов — отдельная ловушка. Датасет 90/10 обучает нейросеть, которая предсказывает большинство всегда и получает 90% accuracy без реального обучения. Решения: выровнять классы случайной выборкой или передать class_weight при компиляции модели.
Аналогия: переучить терапевта в кардиолога занимает полгода, воспитать кардиолога с нуля — 10-15 лет. Трансферное обучение (transfer learning) работает так же.
Схема: берёте готовую предобученную модель — Foundation Model (базовую модель) — замораживаете большинство её слоёв, добавляете несколько слоёв под свою задачу и дообучаете на небольшом датасете от 500 примеров.
Hugging Face предоставляет тысячи готовых моделей: BERT, RoBERTa, DistilBERT — одной строкой кода через AutoModel.from_pretrained().
Когда выбирать дообучение (fine-tuning):
| Параметр |
Трансферное обучение |
Обучение с нуля |
|---|---|---|
| Нужные данные | от 500 примеров | 100 000+ примеров |
| Время обучения | Часы | Недели–месяцы |
| Вычисления | Средние (1 GPU достаточно) | Высокие (кластер GPU) |
| Точность | Высокая (базовая модель уже обучена) | Зависит от объёма данных |
Трансферное обучение — стандартный путь для большинства практических задач: экономит месяцы работы и даёт сопоставимую точность при значительно меньших вычислениях.
Классический подход «собери датасет — обучи» здесь не работает. У игрового агента нет готовых правильных ответов — он учится на последствиях своих действий.
Это парадигма обучения с подкреплением (Reinforcement Learning, RL) — принципиально другой способ обучения нейросети по сравнению с классификацией. Агент взаимодействует со средой, получает вознаграждения за хорошие действия и штрафы за плохие, постепенно улучшая стратегию.
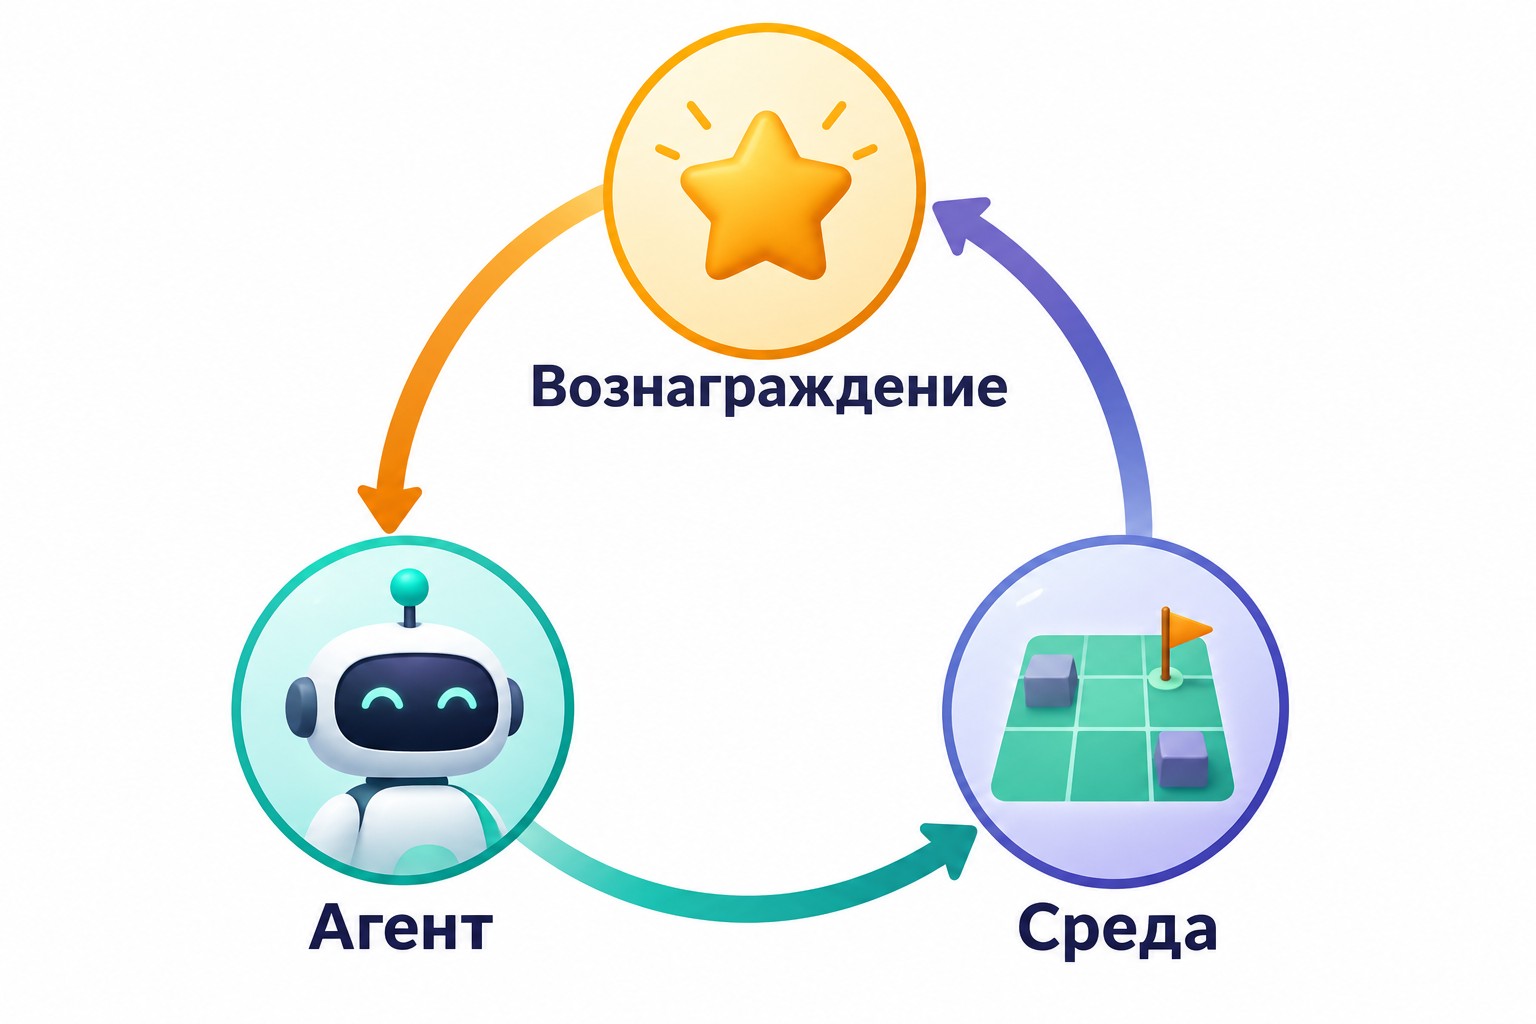
Три компонента системы:
Ключевое отличие от обучения с учителем: нет размеченного датасета. Агент сам исследует среду, иногда делает случайные действия («исследование») и постепенно формирует политику — стратегию выбора действий.
CartPole из OpenAI Gymnasium — стандартная задача для старта в RL. Простая среда, обучается за минуты на CPU.
Для старта: pip install gymnasium, среда CartPole-v1, алгоритм Q-learning или DQN. Google Colab с T4 GPU даёт достаточно мощности для Atari-сред бесплатно. Когда выбирать алгоритм: CartPole и простые Atari → DQN; роботика и сложная динамика → PPO.
Принцип тот же, что и в трансферном обучении: берёте готовую TTS-модель (Text-to-Speech, синтез речи), дообучаете на записях вашего голоса, получаете синтезатор с вашей тембровой характеристикой.
Датасет голоса: 30-60 минут чистых записей без фонового шума и посторонних звуков. Чем больше объём — тем лучше результат. Формат: отдельные аудиофайлы с текстовыми транскрипциями.
Как нейросеть «слышит» голос: аудиосигнал преобразуется в мел-спектрограмму (mel-spectrogram) — двумерное представление, где ось X — время, ось Y — мел-частоты. Это аналог эмбеддинга для звука: компактное числовое представление, сохраняющее тембровые и интонационные характеристики речи.
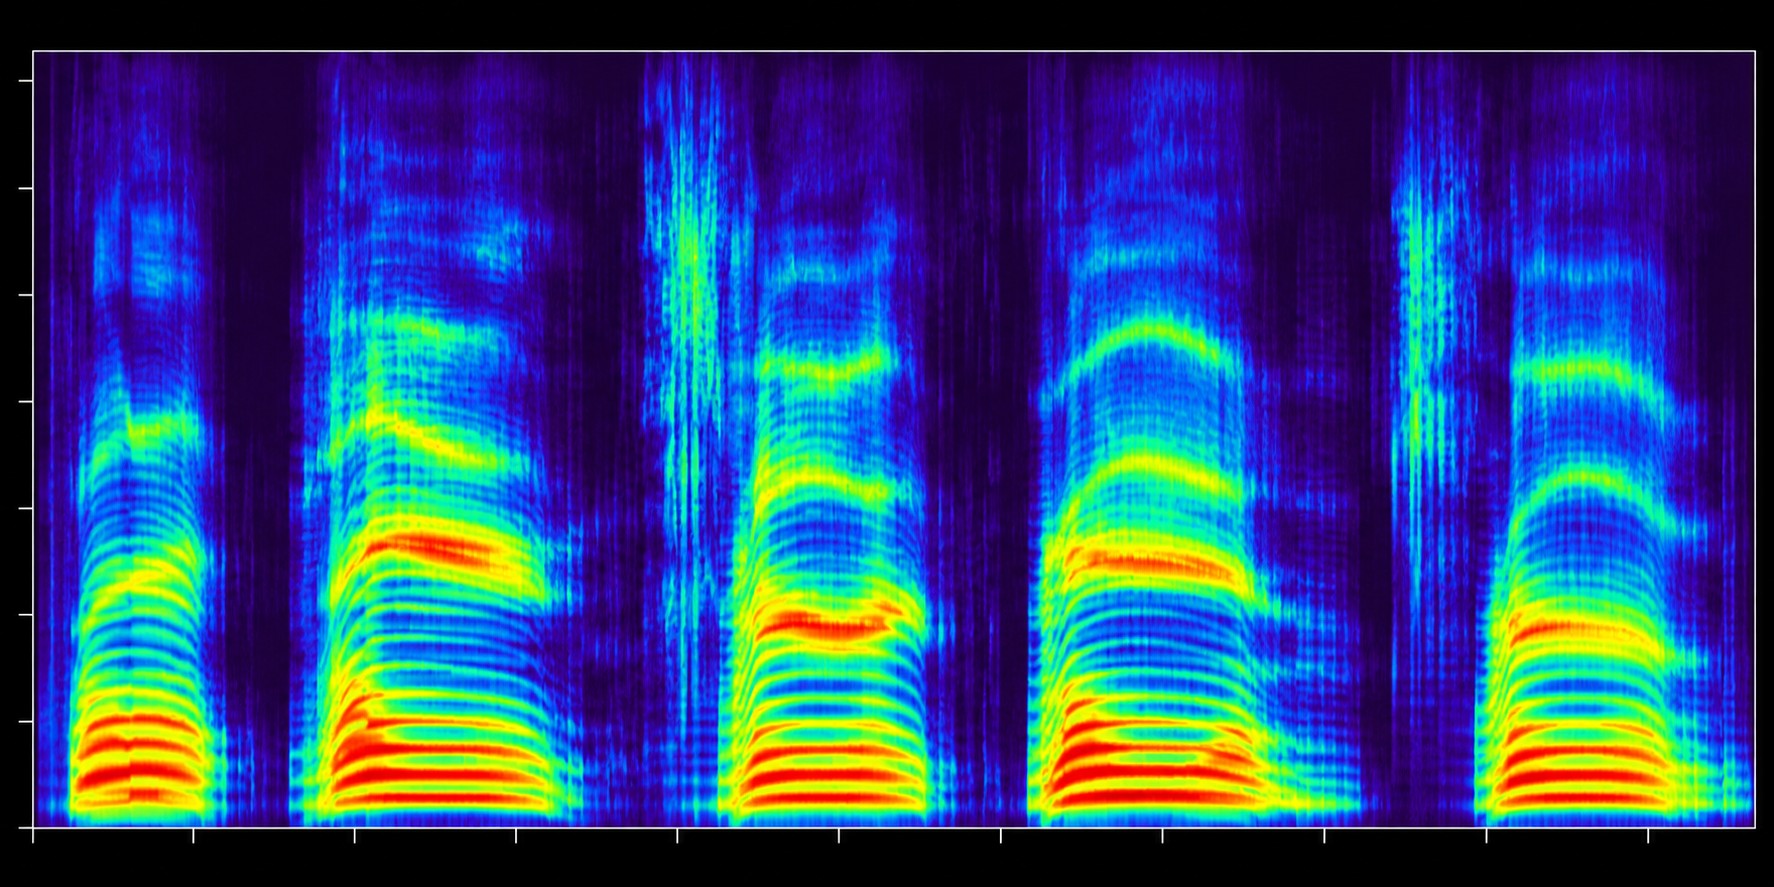
Инструменты для клонирования голоса:
Ограничения: клонирование голоса попадает в зону deepfake-рисков. Использование без согласия человека незаконно во многих юрисдикциях. Инструменты предназначены для создания голосовых ассистентов, озвучки собственных проектов и авторского контента.
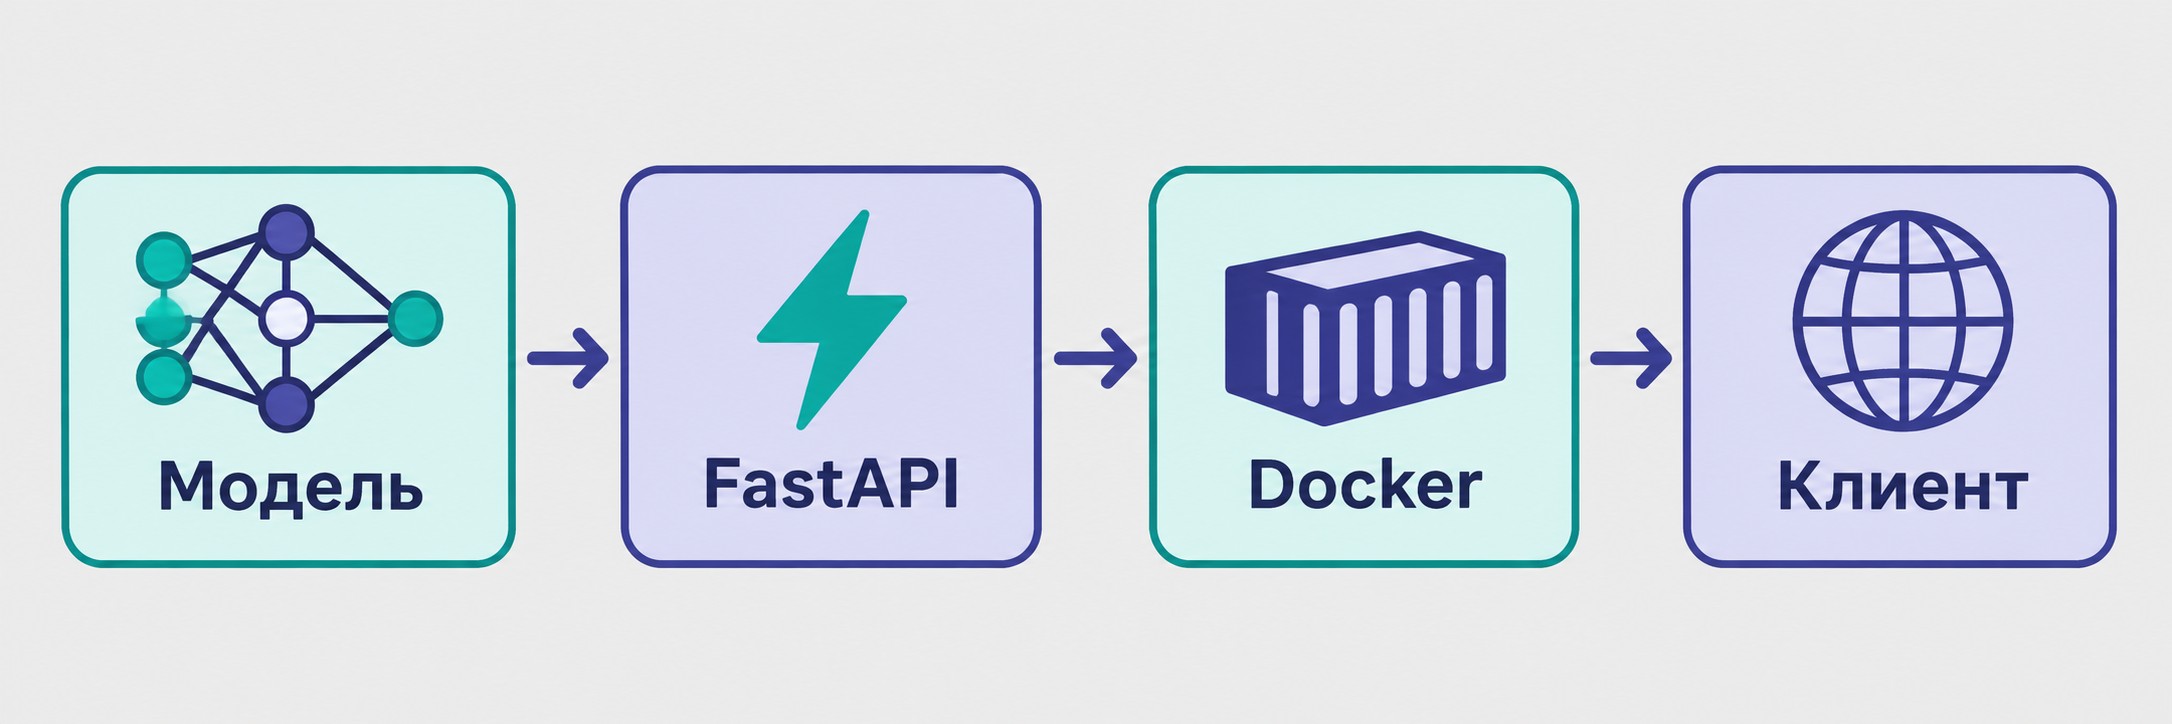
Обученная модель лежит в файле — её нужно «подключить к миру». Деплой — это упаковка нейросети в сервис, который принимает запросы и возвращает предсказания.
Четыре варианта развёртывания:
Загрузка модели в Python: tf.keras.models.load_model(‘model.keras’). Дополнительно загрузите токенизатор через pickle.load(). Оба файла обязательны: без токенизатора модель не обработает входной текст.
Нейросеть учится так же, как человек учится на ошибках: делает предсказание, сравнивает с правильным ответом (функция потерь считает штраф), корректирует внутренние параметры через оптимизатор и пробует снова. Так проходят тысячи итераций по датасету. Чем больше примеров и эпох — тем точнее модель.
Начните с Google Colab — Python уже настроен, установка ничего не нужна. Освойте базовый синтаксис Python, затем изучите TensorFlow/Keras: библиотека позволяет собирать нейросеть как конструктор из слоёв. Первый рабочий классификатор запускается за 1-2 дня, следуя пошаговым туториалам на Kaggle.
Для учебного проекта достаточно 100-500 примеров. Для рабочего классификатора — от 10 000 строк. Серьёзные языковые модели (GPT, BERT) обучены на терабайтах. Правило: чем глубже архитектура и сложнее задача, тем больше данных нужно для обобщения без переобучения.
Учебная модель на 100 примерах в Google Colab обучается за секунды. Модель с LSTM на 10 000 строк — несколько минут на GPU. Крупные Transformer-модели обучают неделями на кластерах. Трансферное обучение сокращает время в десятки раз: вместо месяцев — часы.
Дообучение — адаптация готовой модели (BERT, GPT) к вашей задаче на небольшом датасете от 500 примеров. Обучение с нуля — создание архитектуры и обучение на миллионах строк. Fine-tuning экономит месяцы работы, даёт сопоставимую точность и требует в разы меньше вычислений.
Начните с CartPole из OpenAI Gymnasium — простая среда обучается за минуты на CPU. Q-learning в базовом варианте работает даже на слабом железе. Для сложных сред — Atari, 3D-игры — Google Colab с T4 GPU даёт достаточно мощности бесплатно.
Для RVC достаточно 10-30 минут чистых записей. YourTTS требует от 5 минут. Качество клона растёт с объёмом: 60+ минут дают результат, почти неотличимый от оригинала. Критично: записи без фонового шума и посторонних звуков.
Возможные причины: (1) слишком малый датасет — добавьте данных или используйте трансферное обучение; (2) дисбаланс классов — выровняйте выборку; (3) слишком простая архитектура — замените Dense на LSTM; (4) неподходящий оптимизатор — попробуйте Adam с разными значениями learning rate.
Начинающим — TensorFlow/Keras: высокоуровневый API, конструктор из слоёв, TensorBoard для визуализации метрик. Исследователям — PyTorch: гибкий, питоничный, лучший контроль над вычислениями. Специалистам по NLP — Hugging Face Transformers, работающий поверх обоих фреймворков одновременно.
Текст и аудио нейросеть воспринимает через токенизацию (разбивку на единицы) и эмбеддинги (преобразование в числовые векторы). Для текста — токены слов, для звука — мел-спектрограммы. LSTM или Transformer находит закономерности в последовательностях и выдаёт предсказание.
Превратите интерес к теме в новую профессию
Оставьте заявку — поможем выбрать программу и расскажем об условиях обучения
Оставить заявку


 Задать вопрос


 Задать вопрос