Голосовой бот, который договаривает заученную фразу, пока вы третий раз повторяете «оператора», — знакомая всем сцена. Раздражает не синтетический тембр, а то, что машина физически не может вас услышать, пока говорит сама. 10 сентября 2026 года OpenAI сделала общедоступной в API модель GPT-Live 1, где это ограничение снято на уровне архитектуры. Разбираем, что из этого следует для команд, которые строят голосовые сценарии, — и что делать, если вы в России.
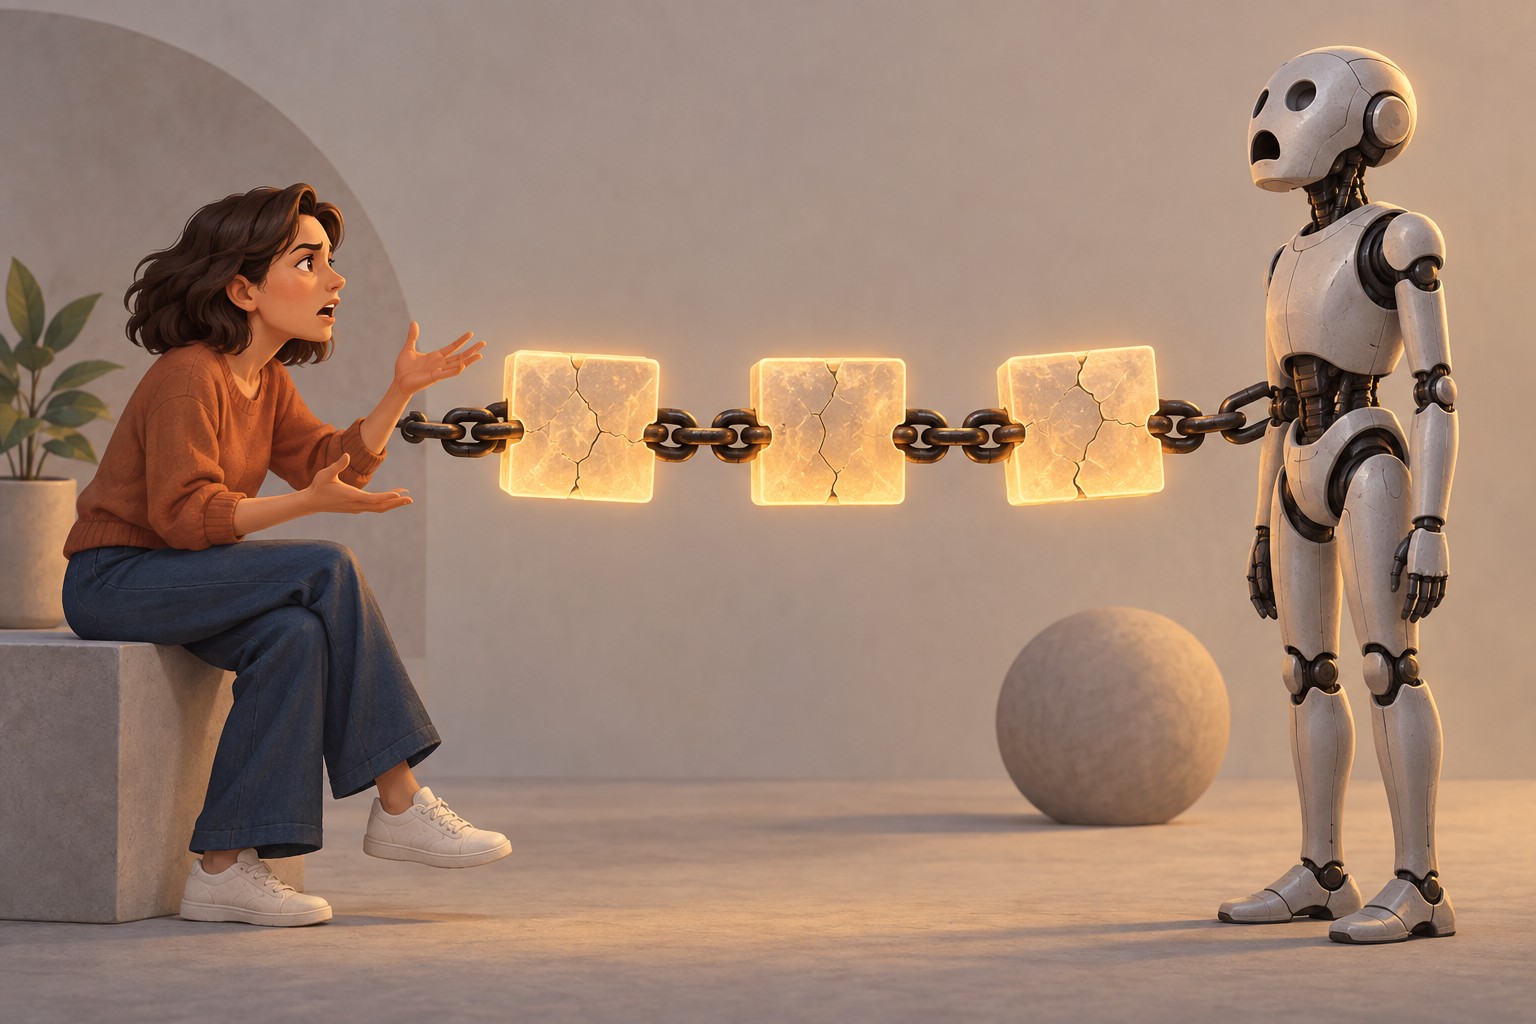
Классический голосовой бот собран из трёх независимых кусков. Сначала распознавание речи (STT) превращает вашу реплику в текст. Потом текст уходит в языковую модель, она думает и возвращает ответ. Потом синтез речи (TTS) озвучивает результат.
Сделайте следующий шаг в карьере
Подберите обучение, которое поможет освоить новые компетенции
Каждое звено добавляет задержку, и задержки складываются. Но хуже другое: пока работает третье звено, первое фактически выключено. Бот «оглох» на время собственной реплики. Отсюда все фирменные болезни: невозможность перебить, паузы в полторы секунды после вашего «да», ответ на реплику, которую вы уже отменили.
Есть и вторая беда — сегментация. Система должна решить, вы закончили говорить или просто задумались. В цепочке это решает таймер тишины: замолчали на 700 миллисекунд — значит, договорили. Живая речь так не устроена, мы делаем паузы в середине мысли, и бот регулярно влезает не вовремя.
Чинить это внутри цепочки можно только компромиссами: уменьшили таймер — бот перебивает, увеличили — он тормозит. Проблема стала решаемой не когда модели поумнели, а когда звенья слили в одно.
Человек пытается достучаться до робота, который его не слышит
GPT-Live 1 (идентификатор модели — gpt-live-1) работает по схеме full-duplex: одна модель обрабатывает входящий и исходящий звук вместе. Она слушает и говорит одновременно — как человек в телефонном разговоре, который слышит «ага» собеседника, не прекращая фразу. Отдельных STT и TTS в этой схеме нет, звук не превращается в текст и обратно.
Прямое следствие — корректная отработка перебиваний. Вы вклиниваетесь, модель это слышит в момент вклинивания и реагирует. Плюс нативная детекция конца реплики: решение «человек договорил» принимает та же модель, которая слышит интонацию, а не таймер тишины.
Второй архитектурный ход интереснее первого. Рассуждения и вызов инструментов OpenAI вынесла наружу: тяжёлую логику выполняет отдельная backend-модель или агент, которого выбирает сам разработчик, а разговор при этом не обрывается. В формулировке changelog это звучит так: голосовая сессия продолжается, пока бэкенд-модель или агент занимается рассуждением и инструментами. На практике это значит, что бот может сказать «секунду, смотрю по вашему заказу» и действительно говорить, пока в фоне идёт запрос к базе.
Из заявленного в анонсе для бизнес-задач: настройка тона, темпа и стиля речи через системный промпт; устойчивость к фоновому шуму и паузам; ASR-транскрипты и текст ответа наравне с аудио; распознавание буквенно-цифровых последовательностей с keyword biasing (номера заказов, артикулы, серии документов); несколько голосов с разными акцентами и языками; поддержка длинных сессий и телефонии.
Важное ограничение, которое стоит проговорить, потому что в пересказах оно теряется: видео и демонстрация экрана не поддерживаются. По документации вход — аудио и текст, выход — аудио и текст. Изображений нет. В самом ChatGPT голосовой режим с видео у GPT-Live тоже не работает, это прямо оговорено в анонсе. Если вам попадался заголовок про «видео-ИИ от OpenAI» — первоисточник его не подтверждает.
Человек и ИИ говорят одновременно — звуковые волны текут в обе стороны
Вендор не публикует цифр экономии, поэтому честно: ниже не обещания эффекта, а зоны, где архитектура full-duplex снимает конкретное техническое препятствие.
Первая линия колл-центра. Не «робот вместо людей», а разбор входящего потока: идентификация клиента, приём номера заказа, ответ на типовой вопрос, маршрутизация. Ровно здесь раньше ломалось всё — клиент перебивал, бот не слышал. Отдельно полезен keyword biasing: номера договоров и артикулы — главная зона ошибок распознавания, и их можно подсказать модели заранее.
Исходящие подтверждения и напоминания. Подтвердить запись к врачу, уточнить адрес доставки, напомнить о платеже. Разговор короткий, сценарий узкий, ошибка дешёвая — с этого разумно начинать пилот.
Онбординг и внутренняя справочная. Новый сотрудник спрашивает голосом, где лежит регламент и как оформить заявку. Логика уходит в бэкенд-агента с доступом к базе знаний, голосовой слой только разговаривает.
Тренажёры для персонала. Отработка сложного клиента для продавцов, менеджеров, операторов. Здесь ценны именно перебивания и смена тона через системный промпт: собеседник ведёт себя неудобно — как настоящий.
Где голосовой ИИ пока не работает: длинные консультации с ответственностью за результат, любые сценарии с деньгами без подтверждения человеком, работа с документами, которые нужно видеть. Модель не видит экран — этот класс задач закрыт по определению.
Модель доступна только на эндпоинте Live sessions — v1/live/sessions. Поддерживаются стриминг и function calling. Обычный chat/completions тут не подойдёт, это отдельный тип соединения, и закладывать работу с ним нужно на этапе проектирования, а не прикручивать к готовому текстовому боту.
Пора сменить профессию? Начните с понятного плана
Подберите программу под ваш опыт, цели и желаемый формат занятости
Цена — 0,05 доллара за минуту голосовой сессии, биллинг посекундный, минуты не округляются. Использование backend-модели и инструментов тарифицируется отдельно по их обычным ставкам: голосовой слой — не весь ваш счёт, а его тонкая часть.
Лимиты заданы числом одновременных сессий и зависят от тира: Tier 1 — 25, Tier 2 — 50, Tier 3 — 200, Tier 4 — 300, Tier 5 — 500. На бесплатном тире модель недоступна. Для колл-центра это первое, что нужно посчитать: не «сколько звонков в день», а сколько параллельных линий в пике.
Кастомный голос под бренд через самообслуживание не сделать — только через обращение в отдел продаж. В поддерживаемое аудио с 31 июля 2026 года добавлена маркировка SynthID.
Самое важное в этом релизе — не то, что модель стала говорить естественнее. Естественность прибавляется каждые полгода, и к ней быстро привыкают. Важно, что OpenAI разделила «разговор» и «мышление» на два независимых слоя: тонкий голосовой интерфейс за 0,05 доллара в минуту и любой бэкенд по вашему выбору.
Это меняет способ проектирования. Голосовой движок перестаёт быть сердцем системы и становится сменной деталью — а сердцем оказывается ваш бэкенд-агент: доступ к CRM, правила, база знаний, логи. И вот тут узкое место, которое релиз не лечит. Если у компании не описаны сценарии, не размечены типовые обращения и не наведён порядок в данных, самая живая речь даст быстрого и вежливого бота, который уверенно говорит не то. Перебивания — решённая проблема. Содержание разговора — нет, и это по-прежнему работа людей.
Для российских команд у этого разделения есть прямое практическое следствие, о нём ниже.
Официально GPT-Live 1 в России недоступен. Россия и Беларусь отсутствуют в списке поддерживаемых стран OpenAI, для доступа нужен VPN. Оплата — отдельная преграда: карты МИР и карты российских банков не принимаются ни для подписок ChatGPT, ни для пополнения баланса API, расчёт только в долларах. Посредники-агрегаторы существуют, но это не официальный канал вендора, и рисков — вплоть до блокировки аккаунта за обход гео-ограничений — он не снимает. Отдельная техническая тонкость: Live sessions — это постоянное соединение, а большинство реселлеров проксируют только текстовые эндпоинты, так что «у нас есть доступ к OpenAI» ещё не означает, что голосовой режим через них заработает.
Что есть в российском контуре:
Архитектурно это по-прежнему связка распознавание → модель → синтез, со всеми её задержками. Но благодаря тому же разделению слоёв ваш бэкенд-агент переносим: логика, промпты, доступ к данным пишутся один раз, а голосовой слой меняется. Проектируйте систему так, чтобы движок речи можно было заменить, не переписывая всё остальное.
Развилка дорог: глобальный облачный сервис и российские платформы
Поддерживает ли GPT-Live 1 видео и демонстрацию экрана? Нет. Вход — аудио и текст, выход — аудио и текст. Изображения и видео не поддерживаются, в ChatGPT голосовой режим с видео и демонстрацией экрана у GPT-Live тоже недоступен. OpenAI упоминает, что работает над этим, но сроков не называет.
Сколько стоит минута голосовой сессии GPT-Live 1? 0,05 доллара за минуту, посекундный биллинг без округления. Работа backend-модели и вызываемых инструментов оплачивается отдельно по их обычным тарифам.
Как подключить GPT-Live 1 через API и какой эндпоинт использовать? Модель доступна только на эндпоинте Live sessions — v1/live/sessions, с поддержкой стриминга и function calling. На бесплатном тире её нет; число одновременных сессий ограничено тиром — от 25 на Tier 1 до 500 на Tier 5.
Работает ли голосовой ChatGPT в России без VPN? Нет. России нет в списке поддерживаемых стран, а российские карты не принимаются для оплаты ни подписки, ни API. Обход через посредников — не официальный канал и несёт риск блокировки аккаунта.
Чем GPT-Live 1 отличается от Яндекс SpeechKit и GigaChat по голосовым возможностям? Ключевое отличие архитектурное: GPT-Live 1 обрабатывает входящее и исходящее аудио одной моделью (full-duplex), поэтому лучше отрабатывает перебивания и сам определяет конец реплики. Российские платформы построены на классической связке распознавание → модель → синтез, зато работают без VPN, в рублях и в правовом поле 152-ФЗ.
Превратите интерес к теме в новую профессию
Оставьте заявку — поможем выбрать программу и расскажем об условиях обучения
Оставить заявку


 Задать вопрос


 Задать вопрос